
OrcaSAQ2 27B rivalise avec Claude sur certains benchmarks, sans le dépasser sur SWE-bench Verified. Son intérêt tient aussi à sa taille : quantifié à 3 bits, il passe de 54 Go à 12,3 Go. Reste à distinguer performance mesurée, fidélité au modèle BF16 et comparabilité des tests.
Qu’est-ce qu’OrcaSAQ2 27B ?
OrcaSAQ2 27B est une version quantifiée de Qwen3.8-27B. La quantification réduit la précision utilisée pour représenter les poids du modèle, ce qui diminue son volume sans changer son architecture de base.
Les chiffres donnent une mesure concrète de cette compression : le modèle passe de 54 Go à 12,3 Go, soit une baisse de 77,2 %. Chaque poids est représenté avec une moyenne de 3,21 bits, contre 16 bits en BF16, un format numérique à 16 bits. La moyenne tient au fait que la quantification n’attribue pas nécessairement le même nombre de bits à tous les poids.
Les capacités annoncées couvrent plusieurs usages d’agent :
- Contexte de 262 000 tokens. Le modèle peut traiter une longue séquence de texte dans une même fenêtre de contexte, ce qui est utile quand un agent doit conserver des échanges, du code ou des sorties de terminal.
- Appel d’outils. L’agent peut demander l’exécution d’une action externe, par exemple utiliser un outil disponible dans son environnement.
- Mode réflexion. Ce mode permet au modèle de consacrer une étape à l’élaboration de sa réponse avant de la produire.
- Décodage spéculatif MTP. MTP signifie « Multi-Token Prediction » : le modèle prédit plusieurs tokens, c’est-à-dire des unités de texte, dans le cadre du décodage spéculatif.
Pour un agent de programmation ou de terminal, la combinaison compte davantage qu’une capacité isolée. L’appel d’outils correspond au besoin d’interagir avec l’environnement, tandis que le contexte étendu peut accueillir davantage de code et de sorties de commande. Le mode réflexion est pertinent pour des tâches qui demandent de planifier une action avant de l’exécuter. La taille réduite à 12,3 Go rend aussi le modèle moins volumineux à stocker que sa version de 54 Go. Ces caractéristiques décrivent le modèle ; elles ne suffisent pas, à elles seules, à conclure à ses performances face à Claude.
Comment OrcaSAQ2 réduit-il les poids à 3 bits ?
OrcaSAQ2 réduit la taille des poids en attribuant davantage de précision aux paramètres les plus sensibles aux erreurs et moins aux autres. C’est une quantification mixte sensible à la sensibilité : tous les poids ne sont pas représentés avec le même nombre de bits. La moyenne annoncée est de 3,21 bits par poids.
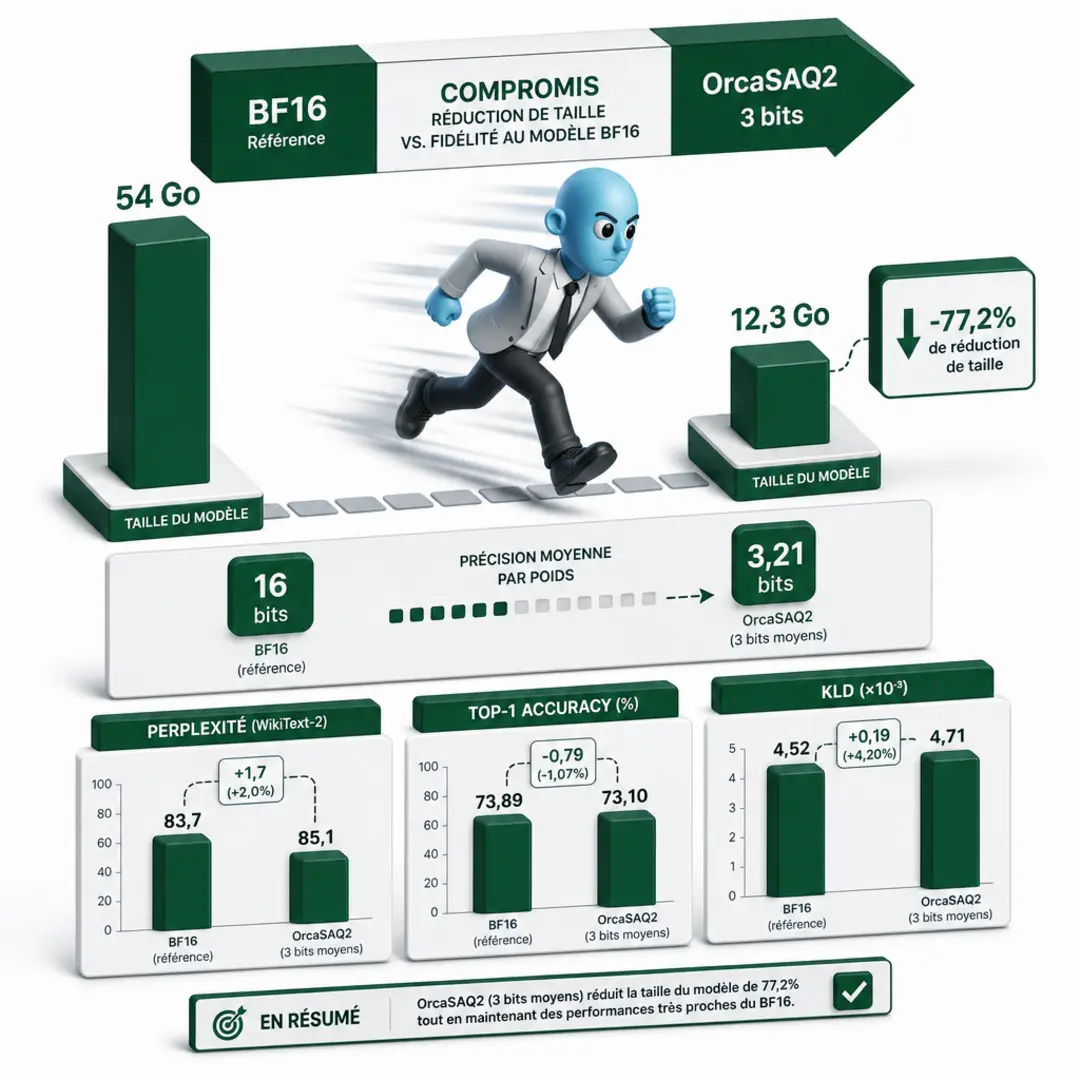
Les résultats publiés sur WikiText-2 indiquent une perplexité de 5,6468 en BF16, contre 5,6482 avec OrcaSAQ2. La perplexité mesure la capacité du modèle à prédire une séquence ; plus elle est basse, mieux c’est. L’écart correspond à une hausse annoncée de 0,02 %. Les autres mesures rapportées sont un accord Top-1 de 93,2 % et une divergence KLD moyenne de 0,031. Le Top-1 compare la prédiction la mieux classée par les deux modèles ; la KLD, ou divergence de Kullback-Leibler, quantifie l’écart entre leurs distributions de probabilité.
La taille annoncée passe de 54 Go à 12,3 Go. Ces chiffres suggèrent une forte réduction du stockage avec une variation limitée des mesures présentées. Ils ne suffisent toutefois pas à reproduire la méthode ni à vérifier ses performances sur d’autres tâches.
Les détails de calibration, les règles d’allocation de précision et les techniques de stockage ne sont pas divulgués. On ne peut donc pas déduire précisément quels paramètres reçoivent plus de bits, comment leur sensibilité est évaluée, ni comment les poids quantifiés sont empaquetés. La description permet de caractériser le principe général, pas la procédure d’implémentation.
| Mesure | BF16 | OrcaSAQ2 |
| Perplexité WikiText-2 | 5,6468 | 5,6482 |
| Hausse de perplexité annoncée | 0,02 % | |
| Accord Top-1 | 93,2 % | |
| Divergence KLD moyenne | 0,031 | |
| Bits moyens par poids | 3,21 | |
| Taille | 54 Go | 12,3 Go |
Pourquoi tester des agents au-delà de la perplexité ?
Non. La perplexité mesure la capacité d’un modèle à prédire le prochain token dans un texte fixe. Un benchmark d’agent évalue autre chose : l’exécution d’une tâche interactive, où les actions du modèle modifient l’environnement et déterminent la suite du travail.
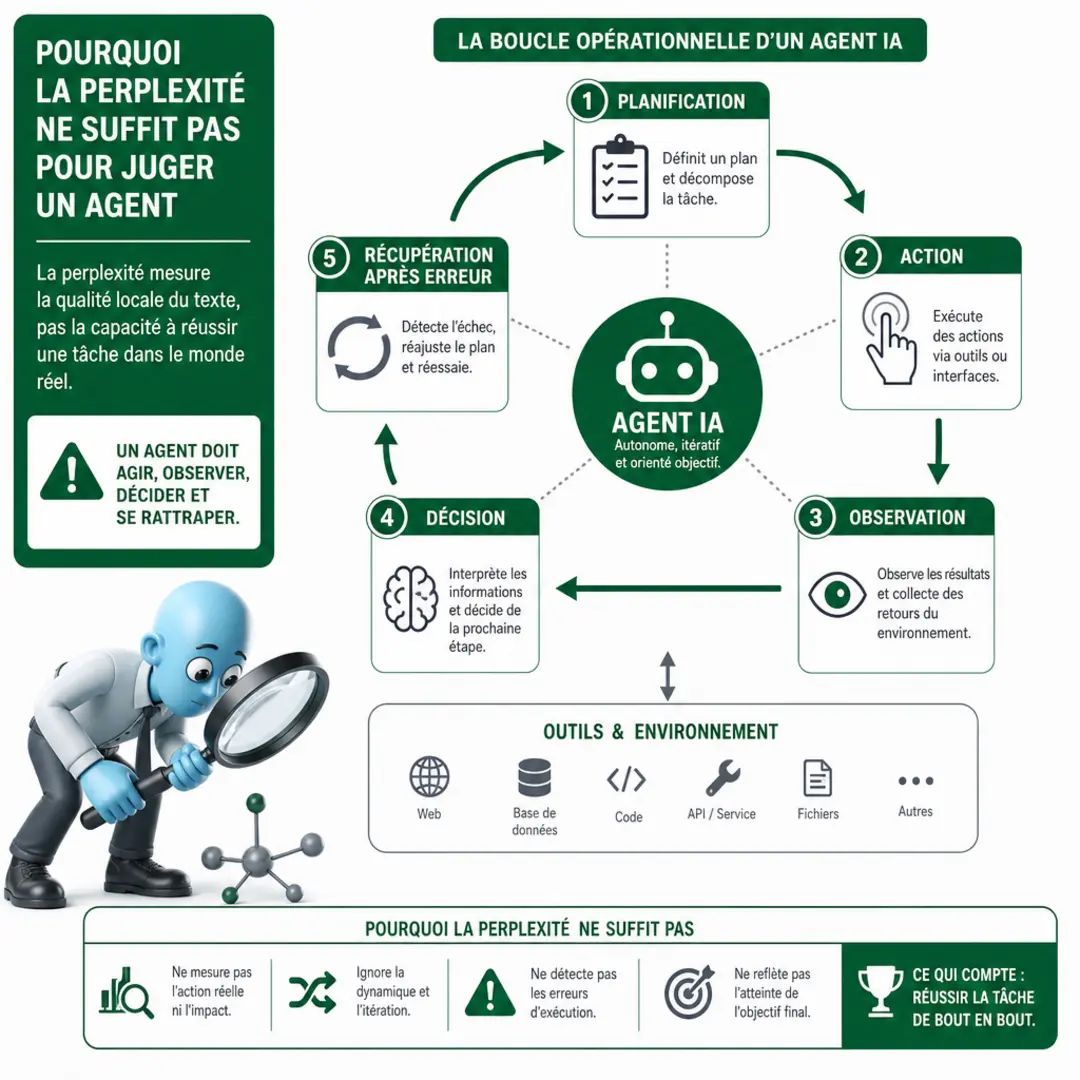
Dans un scénario d’agent, une petite erreur peut avoir des effets en chaîne. Un appel d’outil mal formé peut échouer ; un chemin de fichier incorrect peut viser le mauvais répertoire. L’état de l’environnement change alors, ou ne change pas comme prévu. Les observations suivantes sont différentes, et les décisions qui en découlent peuvent s’éloigner encore davantage de l’objectif. Une bonne prédiction du texte ne garantit donc pas une exécution fiable.
Les benchmarks d’agents évaluent une boucle complète, pas une réponse isolée :
- Planification : décomposer la tâche et choisir une stratégie.
- Action : appeler un outil, modifier un fichier ou exécuter une commande.
- Observation : interpréter le résultat obtenu dans l’environnement.
- Décision : choisir l’étape suivante à partir de ce résultat.
- Récupération : détecter un échec et corriger la trajectoire.
Cette distinction motive l’évaluation d’OrcaSAQ2 sur SWE-bench Verified et Terminal-Bench 2.1. Ces benchmarks permettent d’observer un modèle dans des tâches qui exigent une interaction avec un dépôt logiciel ou un terminal, plutôt que de mesurer uniquement sa prédiction sur un texte. Ils renseignent ainsi sur des capacités opérationnelles que la perplexité ne capture pas directement.
La perplexité reste utile. Elle sert à comparer ou à diagnostiquer la modélisation de séquences textuelles, mais elle ne suffit pas pour conclure qu’un agent sait mener une tâche à terme. Pour OrcaSAQ2, les résultats sur ces benchmarks doivent donc être lus comme une évaluation complémentaire, sans les déduire de la perplexité ni leur attribuer des performances qui ne sont pas documentées.
Que valent ses scores face à Claude ?
Les scores d’OrcaSAQ2 27B sont compétitifs sur certains tests, mais ils ne démontrent pas une supériorité générale face à Claude. Sur SWE-bench Verified, OrcaSAQ2 atteint 70,0 %, contre 79,6 % pour Claude Sonnet 4.6. Sur Terminal-Bench 2.1, l’écart est presque nul : 58,4 % pour OrcaSAQ2, contre 58,5 % pour Claude Sonnet 4.6 avec Claude Code.
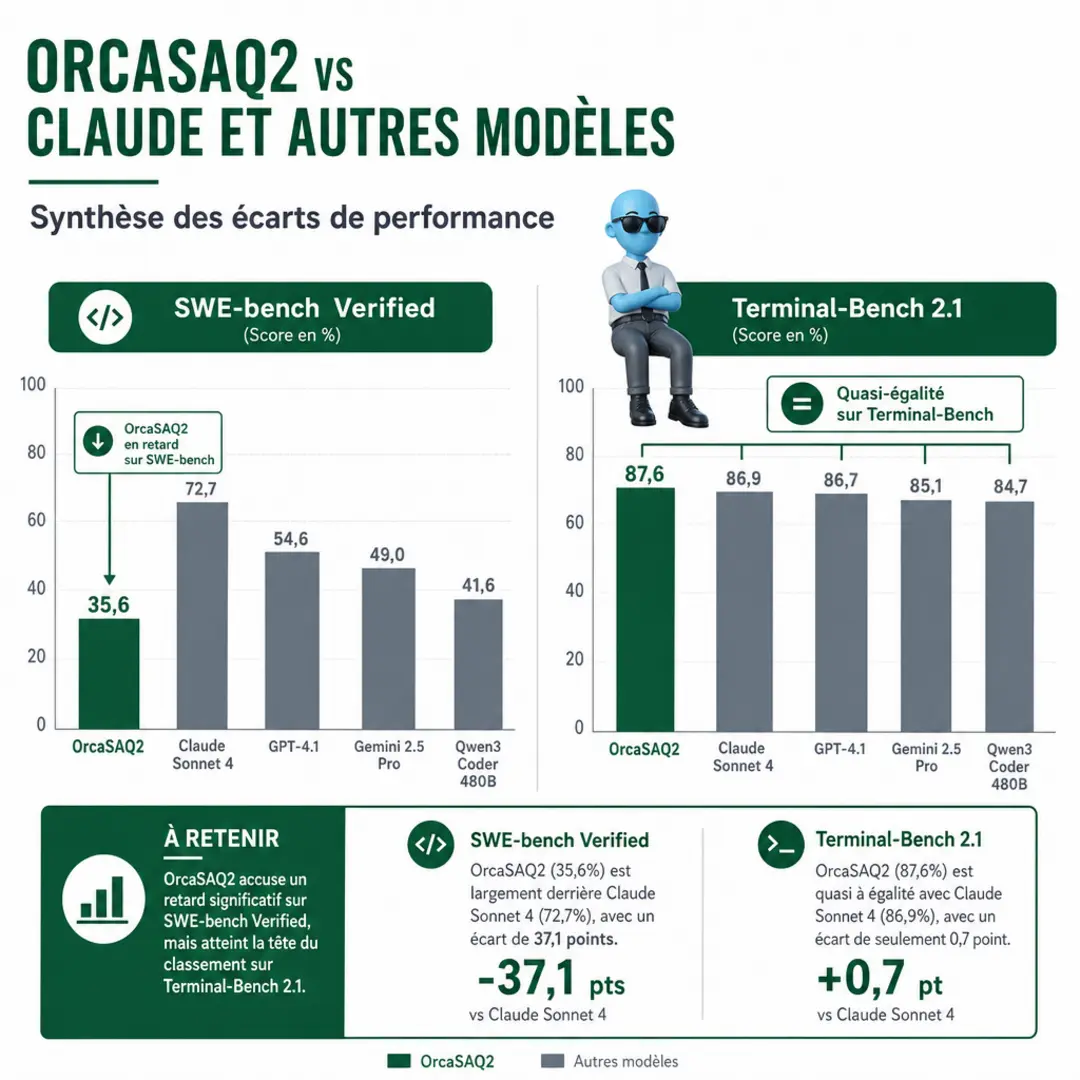
SWE-bench Verified mesure la capacité d’un modèle à résoudre des problèmes issus de dépôts GitHub en proposant des correctifs validés par des tests cachés. Le résultat d’OrcaSAQ2 le place légèrement devant Qwen3-Coder-480B-A35B et Gemini 2.5 Pro sur ce test. Sur Terminal-Bench 2.1, il devance de peu Gemini 3 Flash avec Gemini CLI.
Ces chiffres situent OrcaSAQ2 parmi les modèles compétitifs sur les tâches de programmation évaluées. Ils ne permettent pas de conclure qu’il est globalement meilleur que Claude : les outils, les environnements d’agents et les budgets de raisonnement peuvent différer d’une configuration à l’autre. Les comparaisons sont donc indicatives, pas strictement équivalentes.
| Test | Modèle et configuration rapportés | Score |
| SWE-bench Verified | OrcaSAQ2 27B | 70,0 % |
| SWE-bench Verified | Claude Sonnet 4.6 | 79,6 % |
| SWE-bench Verified | Qwen3-Coder-480B-A35B | 69,6 % |
| SWE-bench Verified | Gemini 2.5 Pro | 63,8 % |
| Terminal-Bench 2.1 | OrcaSAQ2 27B | 58,4 % |
| Terminal-Bench 2.1 | Claude Sonnet 4.6 avec Claude Code | 58,5 % |
| Terminal-Bench 2.1 | Gemini 3 Flash avec Gemini CLI | 56,9 % |
Que faut-il retenir avant de choisir OrcaSAQ2 27B ?
OrcaSAQ2 27B réduit fortement l’empreinte du modèle, de 54 Go à 12,3 Go, tout en conservant une forte fidélité au BF16 selon les mesures publiées. Ses scores atteignent 70,0 % sur SWE-bench Verified et 58,4 % sur Terminal-Bench 2.1. Ils sont compétitifs, mais ne placent pas le modèle au-dessus de Claude sur tous les tests : sur SWE-bench Verified, Claude Sonnet 4.6 obtient 79,6 %.
La perplexité ne suffit pas à juger un agent qui enchaîne outils et décisions. Il faut aussi examiner les résultats en situation et tenir compte des différences de configuration. Pour vous, le bénéfice est concret : évaluer un modèle de programmation plus compact avec des données de fidélité et des benchmarks d’agents, sans confondre proximité de score et équivalence.
FAQ
- Qu’est-ce qu’OrcaSAQ2 27B ?
C’est une version quantifiée de Qwen3.8-27B. Elle passe de 54 Go à 12,3 Go, avec une moyenne de 3,21 bits par poids. - Quelle est la taille d’OrcaSAQ2 27B après quantification ?
La taille annoncée est de 12,3 Go, contre 54 Go pour le modèle BF16, soit une réduction de 77,2 %. - Quel score OrcaSAQ2 obtient-il sur SWE-bench Verified ?
OrcaSAQ2 27B obtient 70,0 %. Claude Sonnet 4.6 atteint 79,6 % dans les résultats rapportés, mais les configurations de comparaison peuvent différer. - OrcaSAQ2 égale-t-il Claude sur Terminal-Bench ?
Son score annoncé est de 58,4 % sur Terminal-Bench 2.1, contre 58,5 % pour Claude Sonnet 4.6 avec Claude Code. Ces résultats sont proches, mais ne garantissent pas une comparaison strictement équivalente. - Pourquoi la perplexité ne suffit-elle pas pour évaluer un agent ?
Elle mesure la prédiction du prochain token dans un texte fixe. Un benchmark d’agent évalue aussi les effets d’une succession d’actions, d’appels d’outils, d’observations et de décisions.
A propos de l’auteur
Je suis Franck Scandolera, expert en data engineering et en automatisation IA. Je m’intéresse à la façon dont les modèles quantifiés peuvent alimenter des workflows agentiques et des applications métier intelligentes, avec des performances mesurables.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.