
Pas toujours. Sonnet 5.5 affiche un tarif par jeton inférieur, mais son mode « max effort » peut consommer assez de jetons de raisonnement pour rapprocher son coût par tâche de celui d’Opus 5.5. Voici comment lire les benchmarks et comparer les dépenses réelles.
Pourquoi le prix par jeton ne suffit-il pas ?
Le tarif unitaire ne suffit pas à comparer le coût réel de Sonnet 5.5 et d’Opus 5.5. Les tarifs par million de jetons d’entrée et de sortie restent exacts, mais la facture dépend aussi du nombre de jetons consommés pour obtenir un résultat exploitable.
Une tâche complexe peut demander plusieurs appels au modèle, des réponses longues ou davantage de raisonnement. Ces jetons de raisonnement sont facturés : ils augmentent le volume consommé, même s’ils ne sont pas toujours visibles dans la réponse finale.
La comparaison dépend donc de la configuration nécessaire pour atteindre le niveau de qualité attendu. Opus 5.5 peut produire un bon résultat sans pousser son effort de raisonnement au maximum. Sonnet 5.5, lui, peut nécessiter le mode « max effort » sur certaines tâches. Son prix unitaire inférieur peut alors être partiellement compensé, voire annulé, par un volume de jetons plus élevé.
Ce qu’il faut comparer pour une même tâche :
| Modèle | Coût à examiner | Point de vigilance |
| Opus 5.5 | Prix des jetons consommés | Un effort de raisonnement moins élevé peut suffire. |
| Sonnet 5.5 | Prix des jetons consommés | Le mode « max effort » peut augmenter le volume facturé. |
Le bon indicateur est donc le coût total pour une tâche réussie, avec une qualité comparable, et non le seul prix par million de jetons. En pratique, je mesure le volume d’entrée, de sortie et de raisonnement sur vos propres cas d’usage. C’est souvent là que l’écart entre le tarif affiché et le coût opérationnel apparaît.
Que révèlent les coûts par tâche rapportés ?
Les chiffres rapportés placent Claude Sonnet 5.5 et Claude Opus 5.5 autour de 6 à 8 dollars par tâche. À ce niveau, Sonnet n’apparaît pas moins cher qu’Opus dans la comparaison citée, notamment lorsqu’il est utilisé en « max effort ».
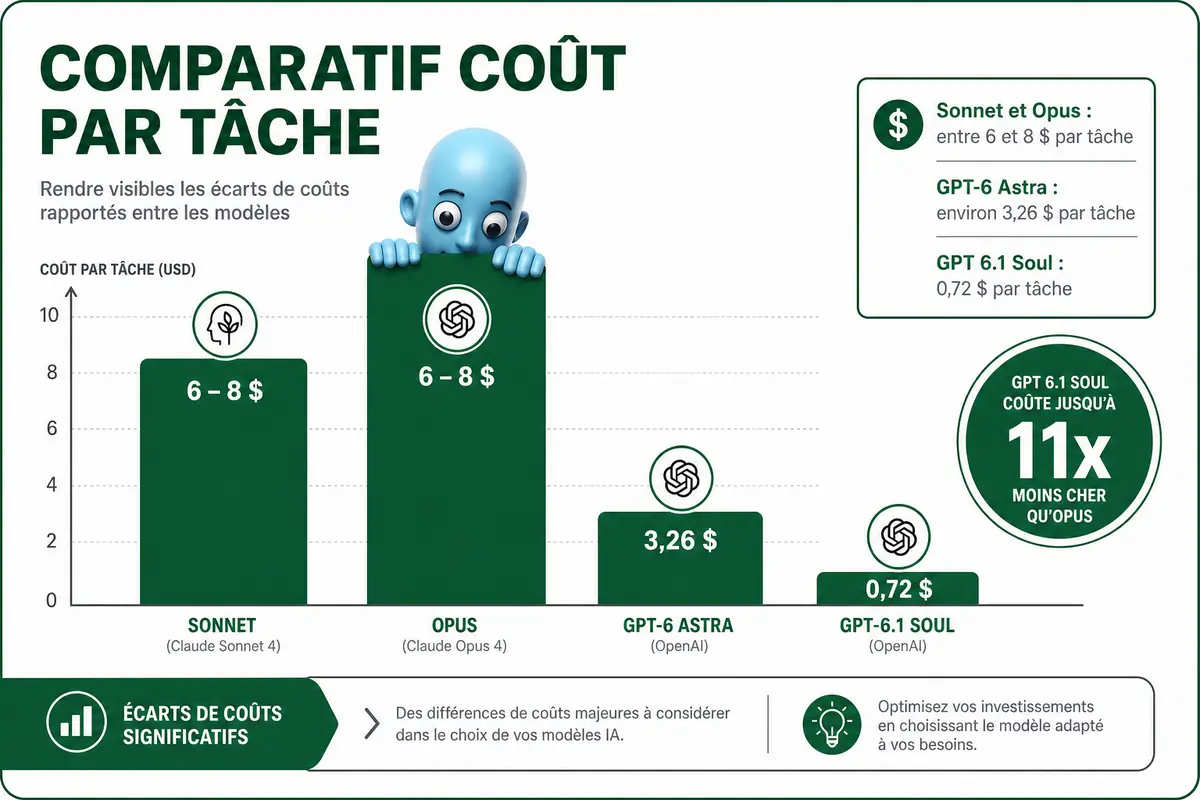
Les estimations rapportées pour les deux modèles GPT sont plus basses :
| Modèle | Coût estimé par tâche |
| GPT-6 Astra | Environ 3,26 dollars |
| GPT 6.1 Soul | Environ 0,72 dollar |
Ces montants sont des chiffres rapportés dans le cadre de comparaisons de benchmarks. Ils ne décrivent pas un coût universel applicable à chaque usage en production. Le coût réel dépendrait du contexte d’utilisation, mais les données fournies ici ne permettent pas de le chiffrer.
Les deux modèles GPT cités obtiennent des scores d’intelligence proches de ceux des modèles Anthropic concernés, mais légèrement inférieurs. Cette proximité ne signifie pas que leurs coûts ou leurs performances sont identiques : les chiffres de coût restent ceux rapportés pour les tâches évaluées.
Le constat central est donc précis : Sonnet en « max effort » peut coûter autant qu’Opus, sans avantage de performance équivalent. Sur la base de ces chiffres, le nom « Sonnet » ne suffit pas à garantir un coût inférieur. La comparaison doit rester attachée aux tâches et aux benchmarks qui ont produit ces estimations.
Quand le mode max effort se justifie-t-il ?
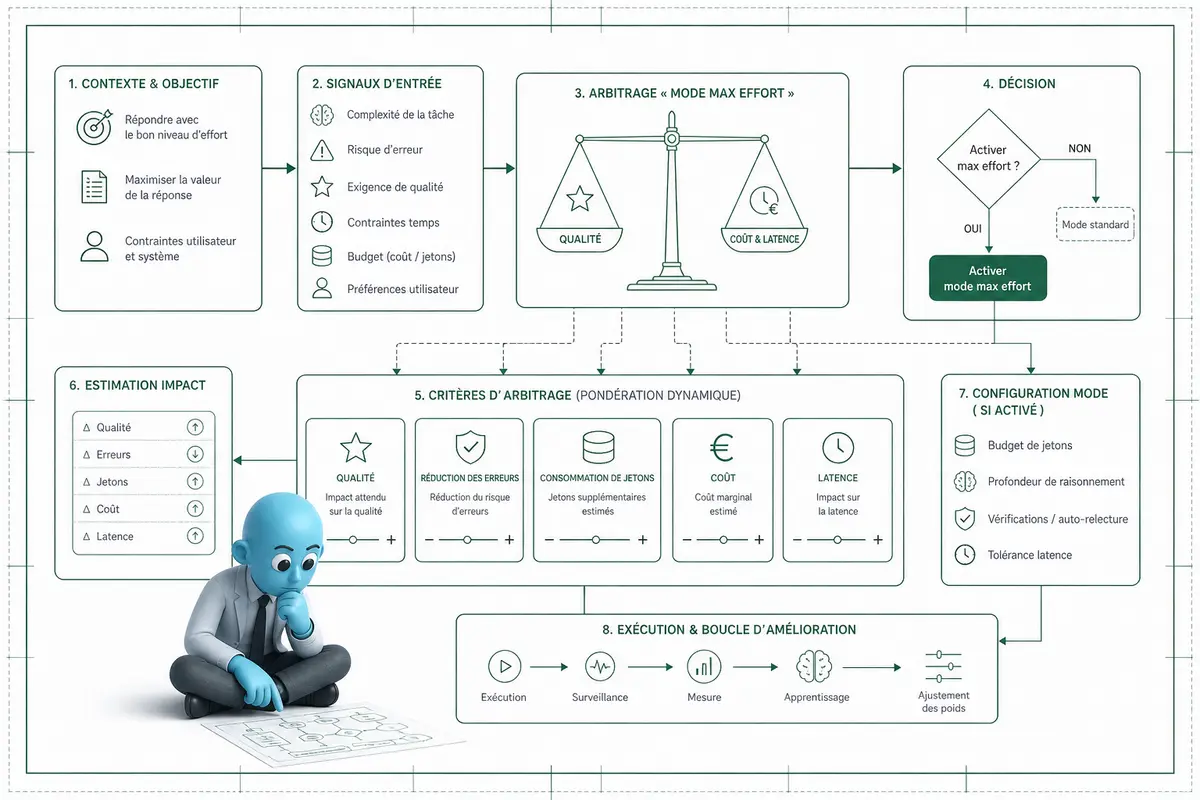
Le mode « max effort » se justifie quand une tâche exige un raisonnement plus approfondi et que le gain obtenu vaut le coût et la latence supplémentaires. Je le réserverais aux problèmes où une réponse rapide mais approximative entraîne des reprises, des erreurs ou des actions incorrectes.
Il peut être pertinent pour du codage en plusieurs étapes, par exemple quand le modèle doit comprendre une base de code, modifier plusieurs composants, puis vérifier la cohérence de l’ensemble. Même logique pour une longue chaîne d’outils : chaque appel peut dépendre du résultat du précédent, et une mauvaise décision en amont peut dégrader toute l’exécution. Des consignes ambiguës peuvent aussi bénéficier d’un effort accru, surtout si le modèle doit comparer plusieurs interprétations avant d’agir.
Mais davantage d’effort n’est pas gratuit. Selon la configuration et la tâche, il peut augmenter le volume de jetons facturés et allonger le temps d’exécution. Le coût réel dépend donc du modèle, des paramètres utilisés, de la longueur des échanges et du nombre d’appels aux outils. Le score d’un benchmark ne suffit pas à l’estimer.
Les classements publient souvent le meilleur résultat obtenu avec la configuration la plus coûteuse. Ce score mesure une performance maximale dans des conditions données, pas nécessairement le comportement ni le coût d’un déploiement avec les réglages par défaut. C’est une distinction importante : le meilleur résultat possible n’est pas automatiquement le meilleur choix opérationnel.
En production, je comparerais les configurations sur vos tâches réelles, en observant à la fois la qualité, le coût par exécution et la latence. Le mode max effort a du sens quand il réduit suffisamment les erreurs ou les reprises pour compenser son surcoût. Sans mesure sur votre propre usage, choisir la configuration la plus coûteuse revient à payer pour une performance théorique, pas nécessairement utile.
Comment comparer les coûts pour vos tâches ?
Pour savoir si Claude Sonnet 5.5 coûte réellement moins cher qu’Opus, je compare les deux modèles sur des tâches réelles, avec les réglages prévus en production. Le prix par million de jetons ne suffit pas : je mesure le coût par tâche et le résultat utile obtenu.
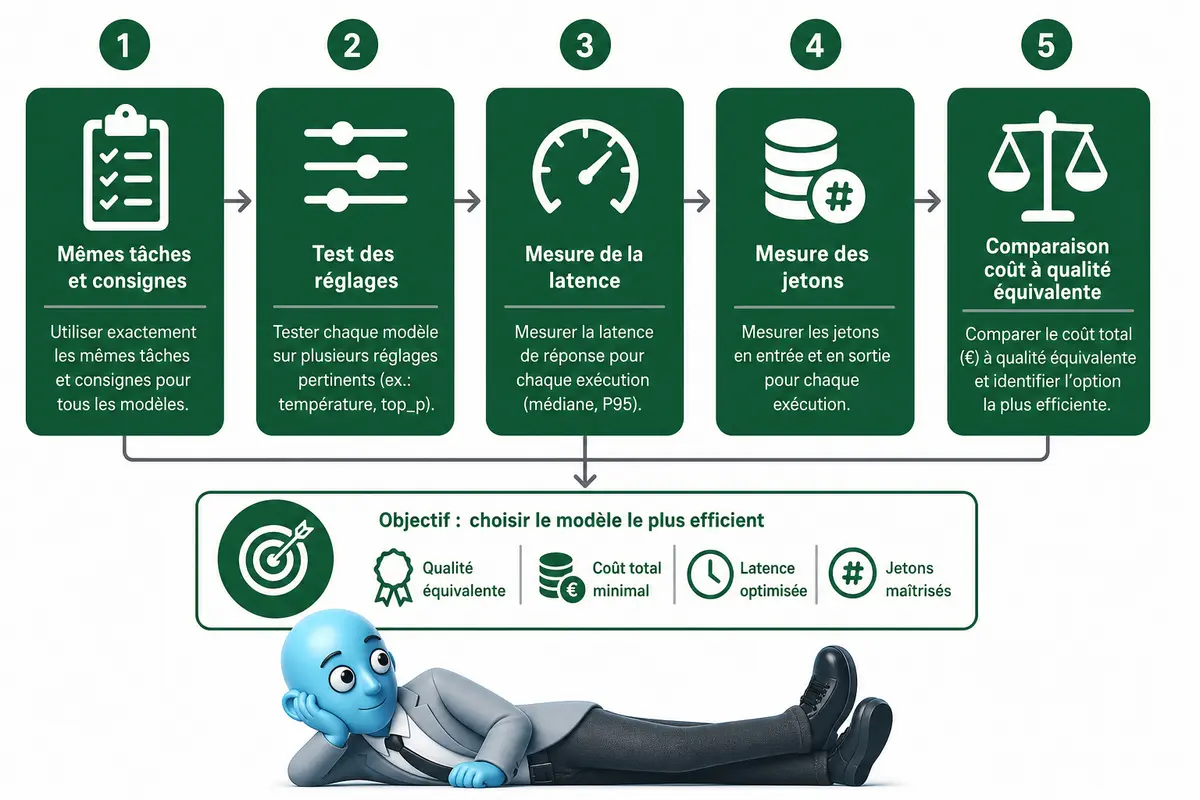
Je construis un test représentatif du travail confié aux modèles. Les entrées, les consignes et les critères d’évaluation restent identiques, sinon la comparaison n’est pas exploitable. Je teste d’abord les réglages par défaut, puis le mode « max effort » quand la tâche justifie davantage de raisonnement.
Pour chaque tâche et chaque configuration, je relève :
- Les jetons d’entrée, de sortie et de raisonnement qui sont facturés.
- La latence, c’est-à-dire le temps nécessaire pour obtenir la réponse.
- La qualité selon les mêmes critères, par exemple l’exactitude ou le respect du format attendu.
- Le coût total pour produire un résultat réellement utilisable, en tenant compte des éventuelles reprises nécessaires.
Je compare ensuite les résultats à qualité équivalente, ou je rends visible le compromis si l’un des modèles répond plus vite, coûte moins cher ou exige moins de corrections. Une réponse moins coûteuse mais inutilisable n’est pas une économie. Et si le mode « max effort » améliore la qualité, son surcoût doit être évalué sur cette tâche précise, pas supposé rentable par défaut.
Un benchmark ne permet pas de conclure pour tous les usages. La synthèse doit rester liée au jeu de tâches, aux réglages et aux critères testés ; les usages de votre production peuvent donner un classement différent.
| Critère | À mesurer | Pourquoi |
| Tâches | Des tâches représentatives avec les mêmes entrées et consignes | Comparer les modèles dans des conditions identiques |
| Réglages | Valeurs par défaut, puis « max effort » si pertinent | Évaluer le coût des configurations réellement envisagées |
| Consommation | Jetons d’entrée, de sortie et de raisonnement facturés | Calculer le coût total par tâche |
| Résultat | Latence, qualité et résultat utile obtenu | Mettre le coût en regard de la valeur produite |
Quel modèle choisir pour votre usage réel ?
Le tarif par jeton ne suffit pas à départager Sonnet 5.5 et Opus 5.5. En mode « max effort », les jetons de raisonnement supplémentaires de Sonnet peuvent rapprocher son coût par tâche de celui d’Opus, autour de 6 à 8 dollars dans les chiffres rapportés. Les benchmarks cités ne garantissent pas le même coût ni le même niveau de performance en production : les réglages, la tâche et le volume de raisonnement comptent. Je recommande donc de comparer les modèles sur vos propres cas d’usage, en mesurant coût, latence et qualité avec les configurations réellement prévues. Vous éviterez ainsi de choisir sur un tarif affiché et pourrez maîtriser le coût utile de chaque tâche.
FAQ
-
Claude Sonnet 5.5 est-il moins cher qu’Opus 5.5 ?
Son tarif par jeton est inférieur, mais son coût par tâche peut se rapprocher de celui d’Opus 5.5 si le mode « max effort » génère davantage de jetons de raisonnement facturés. -
Combien coûtent Sonnet 5.5 et Opus 5.5 par tâche ?
Les chiffres rapportés les situent tous deux autour de 6 à 8 dollars par tâche. Ce sont des résultats de benchmark, pas un tarif universel applicable à chaque usage. -
Pourquoi le mode « max effort » peut-il augmenter la facture ?
Il peut mobiliser davantage de jetons de raisonnement. Comme ces jetons sont facturés, le coût total augmente, et la latence peut aussi s’allonger. -
Quand faut-il utiliser le mode « max effort » ?
Il peut être utile pour du codage en plusieurs étapes, de longues chaînes d’outils ou des consignes ambiguës. Il faut vérifier que le gain obtenu justifie le coût et la latence supplémentaires. -
Comment comparer le coût réel de deux modèles ?
Testez-les sur les mêmes tâches et avec les réglages prévus en production. Mesurez le coût par tâche, le volume de jetons, la latence et la qualité obtenue, sans vous limiter au prix par million de jetons.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en Analytics, Data engineering et automatisation IA. J’accompagne les équipes dans l’évaluation des modèles et l’analyse de leurs coûts réels, en reliant les performances mesurées aux usages et aux configurations déployés.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.