
Naive-N0.5-Flash est un modèle de code à poids ouverts de 309 milliards de paramètres, dont 15,5 milliards sont activés par jeton. Son contexte d’un million de jetons repose sur une attention hybride. Je détaille son architecture, son entraînement et les ressources nécessaires pour l’exécuter.
Qu’est-ce que Naive-N0.5-Flash ?
Naive-N0.5-Flash est un modèle à poids ouverts de NaiveAI, conçu pour le codage et la recherche en intelligence artificielle. Il s’appuie sur MiMo-V2.5, le modèle de Xiaomi, et combine une capacité totale importante avec une activation partielle des paramètres à chaque jeton.
Le modèle compte 309 milliards de paramètres au total, mais seulement 15,5 milliards sont activés par jeton. Cette distinction décrit le calcul mobilisé pour traiter chaque unité de texte, pas la mémoire nécessaire pour héberger l’ensemble des poids. Les poids sont publiés sous licence MIT.
Son contexte natif atteint un million de jetons. En pratique, cette fenêtre permet de fournir un volume important de texte — par exemple un dépôt de code ou plusieurs documents — dans une même requête. Elle ne signifie pas que le modèle peut être servi avec peu de mémoire : le chargement des poids et le cache d’attention nécessaire au traitement du contexte consomment aussi de la mémoire. Le coût dépend notamment de la longueur des séquences et du nombre de requêtes traitées simultanément.
NaiveRT annonce environ 50 jetons par seconde et par utilisateur en mode standard, et jusqu’à 2 000 en mode Ultrafast. Ce sont des performances annoncées pour la pile d’inférence de NaiveRT, pas des résultats vérifiés indépendamment ni une garantie de débit dans toutes les conditions.
| Tarification API indiquée | Prix par million de jetons |
| Entrée | 0,10 $ |
| Sortie | 0,40 $ |
| Lectures de cache | 0,01 $ |
L’API est prévue, avec ces tarifs annoncés. Le long contexte repose ensuite sur un mécanisme d’attention capable de traiter les relations entre les jetons ; c’est ce mécanisme qu’il faut examiner pour comprendre comment une fenêtre aussi large peut être exploitée.
Comment fonctionne l’attention hybride SWA-DSA ?
Naive-N0.5-Flash combine l’attention à fenêtre glissante SWA (Sliding-Window Attention) et l’attention creuse DSA (DeepSeek Sparse Attention). La SWA limite chaque calcul au contexte local ; la DSA sélectionne des jetons pertinents dans un historique plus long. Le modèle réduit ainsi le périmètre de l’attention sans limiter la conservation de l’historique dans le cache KV (Key-Value, clés-valeurs).
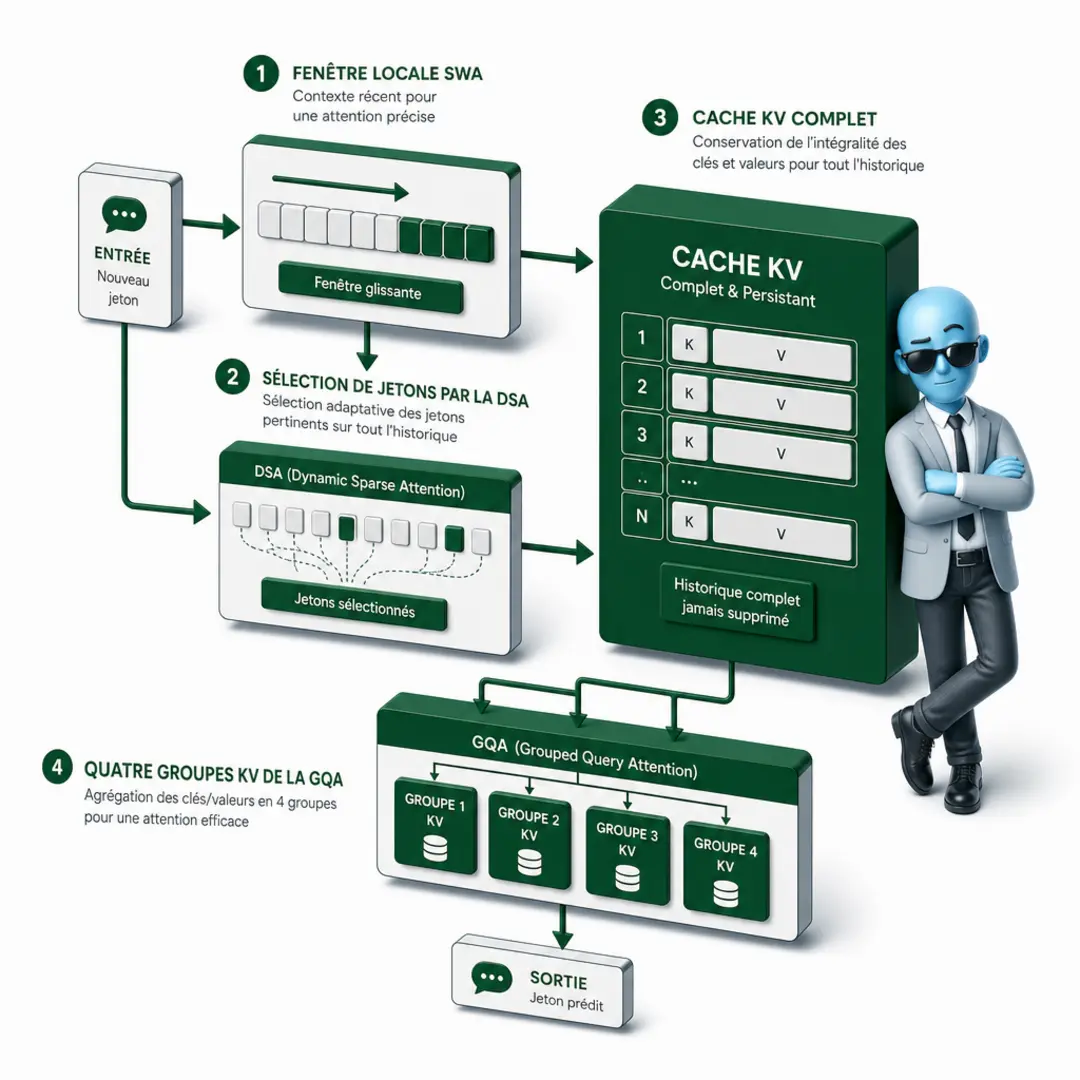
Les 48 couches sont organisées en huit modules de six couches. Elles comprennent 39 couches SWA et 9 couches DSA. La SWA utilise une fenêtre de 128 jetons : chaque couche calcule l’attention sur ce contexte local, avec le biais de sink partagé par les deux mécanismes. Les jetons sink sont des jetons d’ancrage auxquels l’attention accorde un biais spécifique.
Dans les couches DSA, un indexeur à 16 têtes examine la séquence et sélectionne les 2 048 jetons les plus pertinents de l’historique pour le calcul d’attention. Ce parcours par l’indexeur ne signifie pas que l’attention est calculée sur tous les jetons : elle porte uniquement sur la sélection. Le cache KV complet est conservé, tandis que la sélection détermine quels éléments de cet historique participent au calcul. Il faut donc distinguer stockage du contexte et périmètre de l’attention.
La DSA d’origine s’appuie sur la MLA (Multi-head Latent Attention, attention multi-tête à représentation latente). Naive-N0.5-Flash la remplace par une attention standard à requêtes groupées, ou GQA (Grouped-Query Attention), configurée avec quatre groupes KV. La sélection creuse reste portée par l’indexeur ; le mécanisme d’attention utilise cette sélection avec la configuration GQA.
| Mécanisme | Fenêtre ou sélection | Rôle dans l’architecture |
| SWA | Fenêtre de 128 jetons | Attention locale dans 39 couches. |
| DSA | 2 048 jetons sélectionnés par un indexeur à 16 têtes | Attention sur une sélection de l’historique dans 9 couches. |
| Cache KV | Historique complet conservé | Stockage distinct du sous-ensemble utilisé pour calculer l’attention. |
| GQA | Quatre groupes KV | Attention standard à requêtes groupées, en remplacement de la MLA d’origine. |
| Biais de sink | Appliqué en SWA et en DSA | Introduit un biais associé aux jetons d’ancrage dans les deux mécanismes. |
Comment le contexte d’un million de jetons a-t-il été entraîné ?
L’adaptation à l’attention hybride a nécessité 3,25 billions de jetons d’entraînement, à partir du modèle de base MiMo-V2.5 de Xiaomi. Ce volume est réparti en trois phases, chacune identifiable par son intitulé et sa place dans le processus.
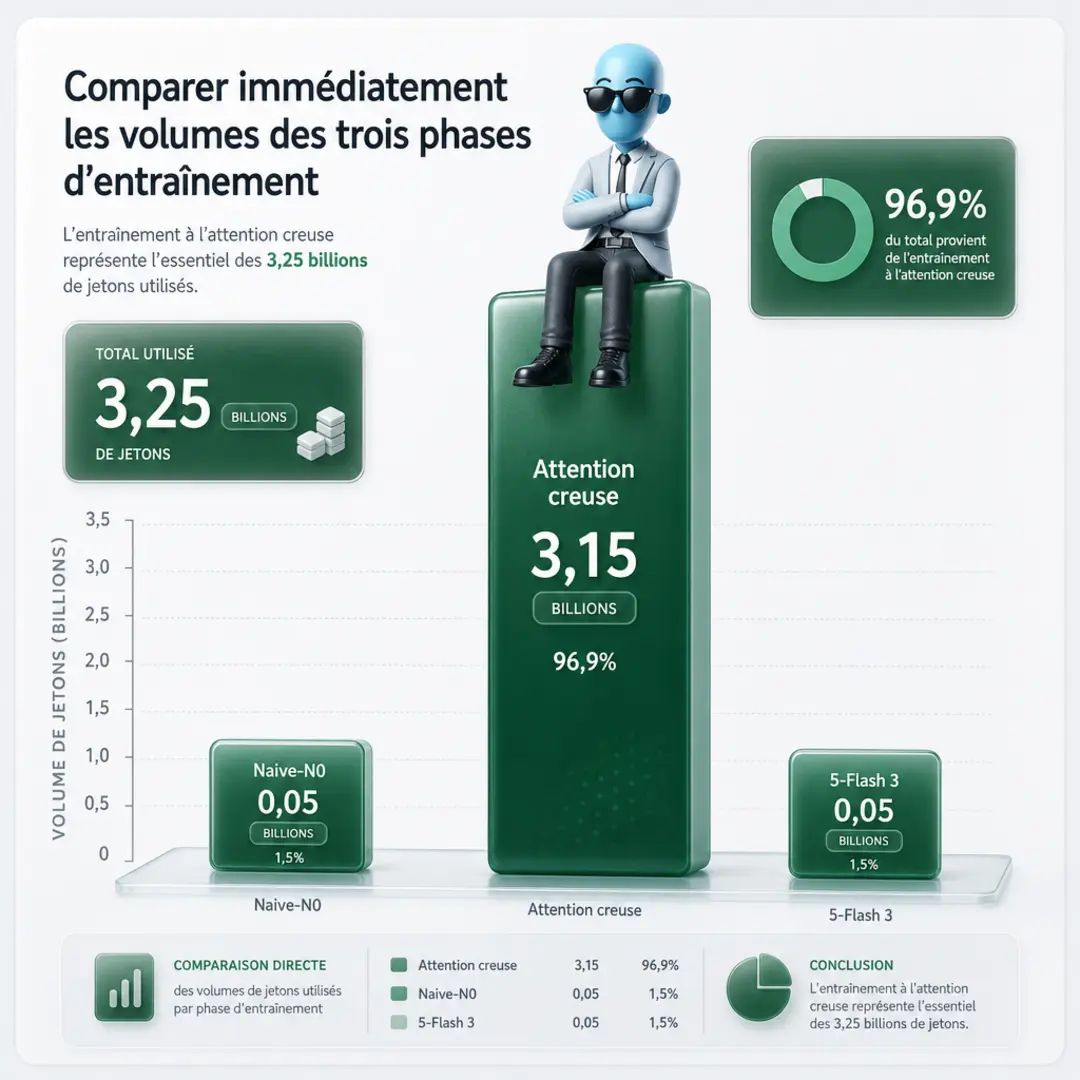
Le préchauffage de l’indexeur mobilise 50 milliards de jetons. Placée en premier, cette phase prépare l’indexeur avant l’entraînement à l’attention creuse. L’intitulé indique son rôle de démarrage, sans permettre d’attribuer à cette étape un résultat mesuré ou une méthode supplémentaire.
L’entraînement à l’attention creuse utilise 3 billions de jetons. C’est la phase centrale et de loin la plus importante en volume. Elle porte sur l’attention creuse, une forme d’attention hybride qui vise à traiter un contexte étendu. Le volume fourni indique l’échelle de l’entraînement, pas une mesure directe de la qualité du modèle.
La dernière phase, la décroissance du taux d’apprentissage, représente 200 milliards de jetons. Elle intervient après l’entraînement à l’attention creuse. Son intitulé désigne une étape où le taux d’apprentissage décroît ; les informations disponibles ne permettent pas de préciser davantage son déroulement ni ses effets mesurés.
Ce travail permet au modèle de prendre en charge un contexte d’un million de jetons. Cette capacité correspond à la longueur de contexte traitable, pas à une garantie de qualité pour toute tâche : les performances dépendent aussi de la nature de la demande et de l’information à retrouver dans le contexte.
| Phase | Volume |
| Préchauffage de l’indexeur | 50 milliards de jetons |
| Entraînement à l’attention creuse | 3 billions de jetons |
| Décroissance du taux d’apprentissage | 200 milliards de jetons |
| Total | 3,25 billions de jetons |
La capacité de contexte ne suffit pas à déterminer les conditions d’exécution : les contraintes matérielles conditionnent l’utilisation réelle du modèle.
Quel matériel faut-il pour l’exécuter localement ?
L’exécution locale de Naive-N0.5-Flash requiert des GPU NVIDIA compatibles FP8 et environ 315 Go pour les poids seuls. Cette capacité ne couvre ni le cache KV, ni les activations, ni les autres surcoûts liés à l’inférence. Les besoins mémoire augmentent avec la longueur du contexte. En pratique, on vise des serveurs multi-GPU, pas une configuration grand public.
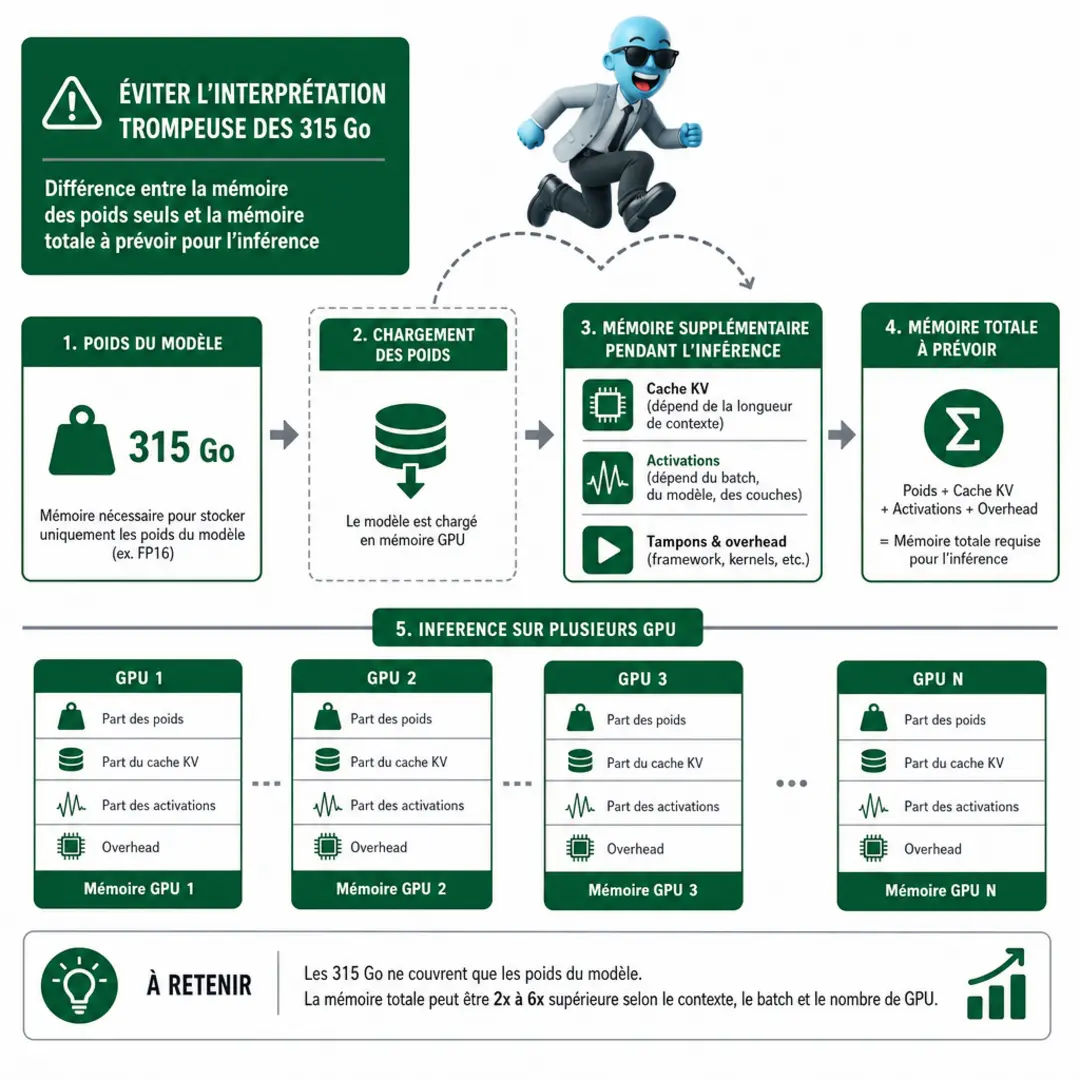
315 Go décimaux correspondent à environ 293,4 GiB. L’exemple Python ci-dessous convertit cette taille et ajoute une réserve saisie par l’utilisateur, exprimée séparément en GiB. C’est une estimation de capacité, pas un calcul de la mémoire totale requise : le script ne calcule ni le cache KV, ni les activations, ni la mémoire d’exécution.
# Convertit les poids en GiB, puis ajoute une réserve fournie par l'utilisateur.
# La réserve est une marge manuelle, pas une estimation des besoins réels.
WEIGHTS_GO = 315
BYTES_PER_GIB = 1024 ** 3
WEIGHTS_GIB = WEIGHTS_GO * 1_000_000_000 / BYTES_PER_GIB

reserve_gib = float(input("Réserve supplémentaire en GiB : "))

if reserve_gib < 0:
    raise ValueError("La réserve doit être positive ou nulle.")

estimated_capacity_gib = WEIGHTS_GIB + reserve_gib

print(f"Poids seuls : {WEIGHTS_GIB:.1f} GiB")
print(f"Capacité estimée avec réserve : {estimated_capacity_gib:.1f} GiB")| Besoins connus | Postes à prévoir sans valeur chiffrée établie |
| GPU NVIDIA compatibles FP8 ; environ 315 Go de poids seuls. | Cache KV, activations, surcoûts d’inférence et mémoire nécessaire au contexte. |
| Exécution pratique orientée vers des serveurs multi-GPU. | Capacité supplémentaire à déterminer selon le contexte et les conditions de service. |
La distinction est importante : la taille des poids décrit uniquement les paramètres du modèle. La mémoire totale nécessaire au service doit aussi absorber les données et les opérations d’inférence. La conversion en GiB ne suffit donc pas à dimensionner une machine.
Que faut-il retenir avant de choisir ce modèle ?
Naive-N0.5-Flash associe 309 milliards de paramètres, une activation de 15,5 milliards par jeton et un contexte natif d’un million de jetons. Son architecture répartit l’attention entre SWA et DSA, après 3,25 billions de jetons d’entraînement dédiés à cette adaptation. Les poids sous licence MIT occupent environ 315 Go et imposent des GPU NVIDIA compatibles FP8 ; le cache KV et les autres besoins s’ajoutent à cette base. Les performances et tarifs évoqués restent ceux annoncés pour NaiveRT et l’API prévue. Avant un déploiement, dimensionnez la mémoire complète et validez les performances dans votre environnement. Vous pouvez ainsi évaluer le coût matériel réel avant d’engager une intégration.
FAQ
-
Qu’est-ce que Naive-N0.5-Flash ?
C’est un modèle à poids ouverts de NaiveAI, conçu pour le codage et la recherche en IA. Il repose sur MiMo-V2.5 de Xiaomi et compte 309 milliards de paramètres, dont 15,5 milliards activés par jeton. -
Quelle est la longueur de contexte de Naive-N0.5-Flash ?
Son contexte natif atteint un million de jetons. Cette capacité ne signifie pas que l’exécution d’un contexte maximal ne consomme pas de mémoire supplémentaire. -
Comment fonctionne l’attention SWA-DSA ?
La SWA utilise une fenêtre de 128 jetons. La DSA sélectionne 2 048 jetons pertinents dans l’historique pour le calcul d’attention, tandis que l’indexeur parcourt la séquence et que le cache KV complet est conservé. -
Quel matériel faut-il pour l’exécuter localement ?
Il faut des GPU NVIDIA compatibles FP8. Les poids occupent environ 315 Go ; le cache KV, les activations et les surcoûts d’inférence nécessitent de la mémoire supplémentaire. L’exécution pratique vise des serveurs mult GPU. -
Naive-N0.5-Flash est-il disponible via une API ?
Une API est annoncée comme prévue, avec des tarifs indiqués de 0,10 $ par million de jetons en entrée, 0,40 $ en sortie et 0,01 $ pour les lectures de cache. Ces informations ne permettent pas de conclure que l’API est déjà disponible.
A propos de l’auteur
Je suis Franck Scandolera, expert en data engineering et en automatisation IA. J’analyse les architectures de modèles et leurs contraintes d’inférence pour aider les équipes à évaluer leur intégration dans des applications métier.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.