
L’API Naive-N0.5-Flash coûte 0,10 $ par million de jetons d’entrée, 0,40 $ en sortie et 0,01 $ pour les jetons lus depuis le cache. Je détaille aussi les modes Standard et Ultrafast, et ce que leur vitesse change pour les agents de programmation.
Quelles sont les caractéristiques de Naive-N0.5-Flash ?
Naive-N0.5-Flash compte 309 milliards de paramètres, dont 15,5 milliards sont actifs. Ses poids sont disponibles sous licence MIT. Ces éléments décrivent la taille du modèle, la part mobilisée lors du calcul et la disponibilité de ses poids ; ils ne permettent pas, à eux seuls, de conclure à un niveau de performance.
Les 309 milliards correspondent au nombre total de paramètres du modèle. Les 15,5 milliards actifs désignent la part de ces paramètres mobilisée pour traiter une requête. Cette distinction peut intéresser les équipes qui évaluent un modèle pour du code ou des agents IA : elle donne une indication sur son fonctionnement et sur les ressources à prendre en compte, sans suffire à estimer le coût réel d’un déploiement.
Pour la programmation, disposer des poids peut permettre d’étudier leur intégration dans une chaîne de développement ou un agent, selon les besoins du projet. Pour un agent IA, cette disponibilité ouvre aussi la possibilité d’évaluer le modèle dans une architecture qui enchaîne plusieurs appels ou s’appuie sur des outils. La pertinence de ces usages dépendra toutefois des besoins techniques et des résultats observés en pratique ; les caractéristiques indiquées ne permettent pas de les présumer.
La licence MIT est associée aux poids du modèle. Elle constitue une information utile pour examiner son intégration dans un projet, mais les seules caractéristiques disponibles ici ne précisent pas les conditions applicables au-delà de cette mention. Elles ne donnent pas non plus le tarif de l’API. Pour savoir combien coûte son utilisation, il faut donc examiner séparément la tarification de l’API Naive-N0.5-Flash.
Combien coûte l’API Naive-N0.5-Flash ?
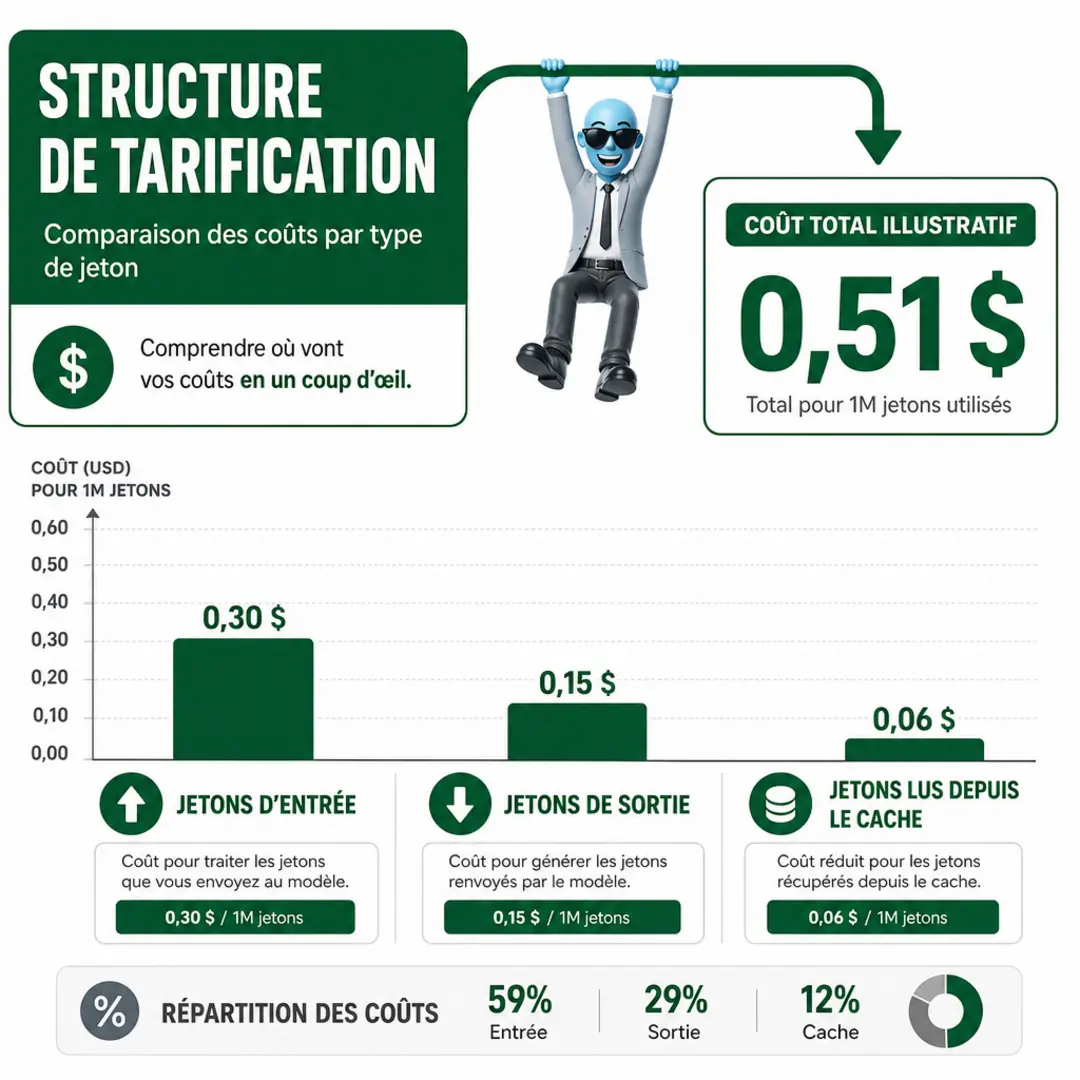
L’API Naive-N0.5-Flash coûte 0,10 $ par million de jetons d’entrée, 0,40 $ par million de jetons de sortie et 0,01 $ par million de jetons lus depuis le cache. Les jetons de sortie coûtent quatre fois plus que les jetons d’entrée. Les lectures depuis le cache coûtent dix fois moins que les entrées ordinaires.
| Type de jetons | Volume | Tarif par million | Coût |
| Entrée | 1 million | 0,10 $ | 0,10 $ |
| Sortie | 1 million | 0,40 $ | 0,40 $ |
| Lecture depuis le cache | 1 million | 0,01 $ | 0,01 $ |
| Total | 3 millions au total, répartis par catégorie | — | 0,51 $ |
Ce calcul applique les tarifs fournis à chaque volume séparément : 0,10 $ + 0,40 $ + 0,01 $ = 0,51 $. Les trois volumes sont exprimés en jetons et les coûts en dollars ; ils ne sont pas additionnés entre eux.
Ce script Python autonome calcule le coût à partir de trois nombres de jetons. Il applique les tarifs par million et affiche le détail ainsi que le total. Il ne déclenche aucun appel à l’API.
# Tarifs en dollars par million de jetons.
TARIF_ENTREE = 0.10
TARIF_SORTIE = 0.40
TARIF_CACHE = 0.01
JETONS_PAR_MILLION = 1_000_000

# Volumes de jetons à facturer.
jetons_entree = 1_000_000
jetons_sortie = 1_000_000
jetons_lus_cache = 1_000_000

# Chaque volume est converti en millions avant application du tarif.
cout_entree = jetons_entree / JETONS_PAR_MILLION * TARIF_ENTREE
cout_sortie = jetons_sortie / JETONS_PAR_MILLION * TARIF_SORTIE
cout_cache = jetons_lus_cache / JETONS_PAR_MILLION * TARIF_CACHE

# Le total additionne les trois postes de facturation.
cout_total = cout_entree + cout_sortie + cout_cache

print(f"Entrée : {cout_entree:.2f} $")
print(f"Sortie : {cout_sortie:.2f} $")
print(f"Lecture depuis le cache : {cout_cache:.2f} $")
print(f"Total : {cout_total:.2f} $")
Le prix ne suffit pas à comparer les modes d’inférence. Le chapitre suivant examine les différences entre ces modes et les critères à prendre en compte au-delà du coût.
Que change le mode Ultrafast ?
Le mode Standard atteint 50 jetons par seconde et par utilisateur, tandis que le mode Ultrafast peut atteindre 2 000 jetons par seconde, soit environ 40 fois plus. Ces chiffres décrivent des performances annoncées, pas une garantie universelle : le débit réel dépend des conditions d’utilisation et de la charge.
Ultrafast vise donc surtout à réduire le temps de génération. Ces valeurs de débit ne donnent pas le prix de l’API et ne permettent pas de déduire un tarif spécifique à ce mode. Sans grille tarifaire confirmée, je ne peux pas affirmer qu’Ultrafast entraîne un coût différent du mode Standard.
NaiveRT mobilise plusieurs mécanismes pour réduire les surcoûts et accélérer la génération : la fusion de méga-noyaux, le Programmatic Dependent Launch et le décodage spéculatif. Je les présente ici comme des leviers d’optimisation mentionnés pour NaiveRT, sans leur attribuer de fonctionnement détaillé qui ne serait pas établi.
Le gain de vitesse compte surtout quand votre application enchaîne plusieurs générations : appels successifs à un modèle, étapes de rédaction ou traitement de nombreuses requêtes. Dans ces workflows, réduire le temps de chaque génération peut raccourcir la durée totale d’exécution. Le mode Ultrafast peut alors être pertinent si la latence est un enjeu, mais le choix doit aussi tenir compte du coût réel et du débit observé sur votre charge.
Pourquoi la vitesse compte-t-elle pour les agents de programmation ?
Une génération plus rapide réduit l’attente lorsque l’agent enchaîne plusieurs étapes. En programmation, il peut lire des fichiers, modifier du code, puis exécuter des tests. Chaque étape peut déclencher une nouvelle génération : le gain de vitesse peut donc rendre l’interaction plus réactive, surtout quand le cycle se répète.
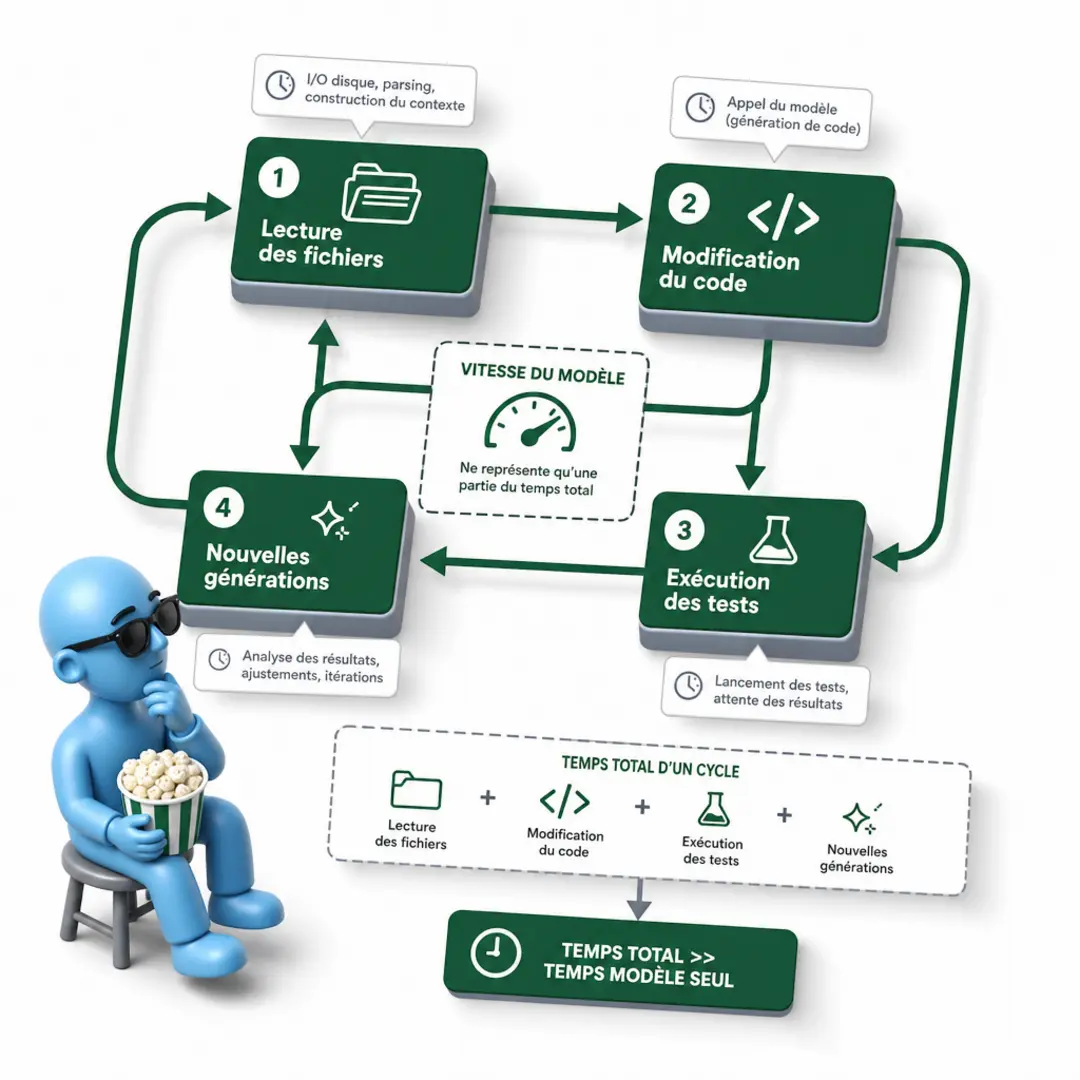
Cette accélération ne prouve pas que le code sera meilleur et ne garantit pas une durée d’exécution précise. Le temps total dépend aussi des outils appelés, des tests, de l’environnement d’exécution et du nombre d’itérations. La vitesse du modèle ne couvre qu’une partie du flux.
Pour estimer le coût avec Naive-N0.5-Flash, je tiens compte du volume de jetons d’entrée, des jetons générés en sortie et des jetons lus depuis le cache. Le mode de vitesse utilisé compte aussi : il faut comparer son tarif au gain de réactivité attendu dans le flux de programmation. Les montants exacts ne figurent pas dans les informations disponibles ici, donc je ne peux pas donner de prix fiable par million de jetons.
| Critère | Donnée fournie | Point à retenir |
| Jetons d’entrée | Le volume d’entrée intervient dans la tarification. | Le mesurer pour estimer le coût. |
| Jetons de sortie | Le volume généré intervient dans la tarification. | Les modifications et réponses de l’agent en consomment. |
| Jetons lus depuis le cache | Ils constituent une catégorie de tarification distincte. | Les comptabiliser séparément. |
| Vitesse | Une génération plus rapide peut réduire l’attente ; aucun débit chiffré n’est fourni. | Le mode de vitesse doit entrer dans le calcul du coût. |
| Usage de programmation | Lecture de fichiers, modification du code et exécution de tests. | Chaque étape peut nécessiter une nouvelle génération. |
Quel critère compte le plus pour votre usage ?
Naive-N0.5-Flash associe des poids sous licence MIT à une API facturée selon les jetons consommés : 0,10 $ par million en entrée, 0,40 $ en sortie et 0,01 $ pour les lectures du cache. Cette différence rend le contexte réutilisé particulièrement intéressant à suivre dans les agents et sessions de programmation. Côté vitesse, le mode Standard atteint 50 jetons par seconde et par utilisateur, contre jusqu’à 2 000 pour Ultrafast. Pour comparer les options, estimez vos volumes de jetons et le nombre d’étapes de génération de vos workflows. Vous pourrez ainsi évaluer le coût et le temps d’attente selon votre usage réel, sans vous appuyer sur une seule métrique.
FAQ
-
Quel est le tarif des jetons d’entrée de Naive-N0.5-Flash ?
Le tarif est de 0,10 $ par million de jetons d’entrée. -
Combien coûtent les jetons de sortie ?
Les jetons de sortie coûtent 0,40 $ par million, soit quatre fois le tarif des jetons d’entrée. -
Quel est le prix des jetons lus depuis le cache ?
Les lectures du cache coûtent 0,01 $ par million de jetons, soit dix fois moins que les entrées ordinaires. -
Quelle vitesse atteint le mode Ultrafast ?
Le mode Ultrafast peut atteindre 2 000 jetons par seconde, contre 50 pour le mode Standard, soit environ 40 fois plus. -
Pourquoi cette vitesse est-elle utile pour un agent de programmation ?
Un agent peut générer du texte à plusieurs étapes, par exemple pour lire des fichiers, modifier du code et exécuter des tests. Une génération plus rapide réduit le temps d’attente entre ces étapes.
A propos de l’auteur
Je suis Franck Scandolera, expert en Data engineering et en automatisation IA. Je conçois des workflows agentiques et des applications métier intelligentes, avec une attention particulière aux coûts d’inférence, à la réutilisation du contexte et à la performance des systèmes.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.