
IQuest-Q1 est un modèle MoE à poids ouverts conçu pour le codage agentique, avec 320 milliards de paramètres et un contexte de 512 000 jetons. Voici son architecture, les évaluations disponibles et les options de déploiement, sans confondre potentiel technique et résultats vérifiés.
Qu’est-ce qu’IQuest-Q1 ?
IQuest-Q1 est un modèle de langage à poids ouverts conçu pour le codage agentique, le raisonnement et l’utilisation d’outils en plusieurs étapes. Le codage agentique consiste à confier une tâche à un modèle qui peut examiner du code, choisir une action, utiliser des outils — par exemple un terminal — puis vérifier le résultat et poursuivre. Il ne se limite donc pas à proposer un extrait de code dans une réponse.
Le modèle compte environ 320 milliards de paramètres au total, mais près de 15 milliards sont activés pour traiter chaque jeton. Un jeton est un morceau de texte, parfois un mot entier, parfois seulement une partie. Cet écart indique que seule une partie des paramètres participe à chaque étape du calcul, au lieu de mobiliser l’ensemble du modèle pour chaque jeton. Le total décrit sa capacité globale ; le nombre activé donne une indication du calcul effectué pour une entrée donnée.
Sa fenêtre de contexte atteint 512 000 jetons. Elle correspond à la quantité de texte que le modèle peut prendre en compte dans une même interaction : du code, des fichiers et des échanges précédents, par exemple. Cette capacité vise des tâches longues où il faut conserver beaucoup de contexte. IQuest-Q1 est aussi destiné à être intégré à des environnements de développement agentiques comme Claude Code et Codex CLI. Il s’agit d’une intégration prévue, pas d’une garantie que toutes les fonctions de ces outils sont déjà disponibles ou prises en charge.
IQuest-Q1 reste un modèle textuel précoce. Je ne lui attribue pas de capacités multimodales : rien ici ne permet de conclure qu’il comprend des images, de l’audio ou de la vidéo. Et comme pour les autres modèles agentiques, les échecs répétés, les décisions erronées et les cas limites non résolus restent possibles. Une grande fenêtre de contexte et l’usage d’outils ne garantissent pas, à eux seuls, un résultat correct.
Comment son architecture MoE fonctionne-t-elle ?
IQuest-Q1 repose sur une architecture de type MoE, ou « mixture of experts » : à chaque jeton, le modèle active 8 experts parmi 256. Le réseau compte 88 couches. Cette organisation répartit le traitement entre plusieurs experts, sans que les 256 soient tous activés pour chaque jeton. Ces caractéristiques décrivent l’architecture ; elles ne garantissent pas, à elles seules, une performance particulière en codage agentique.
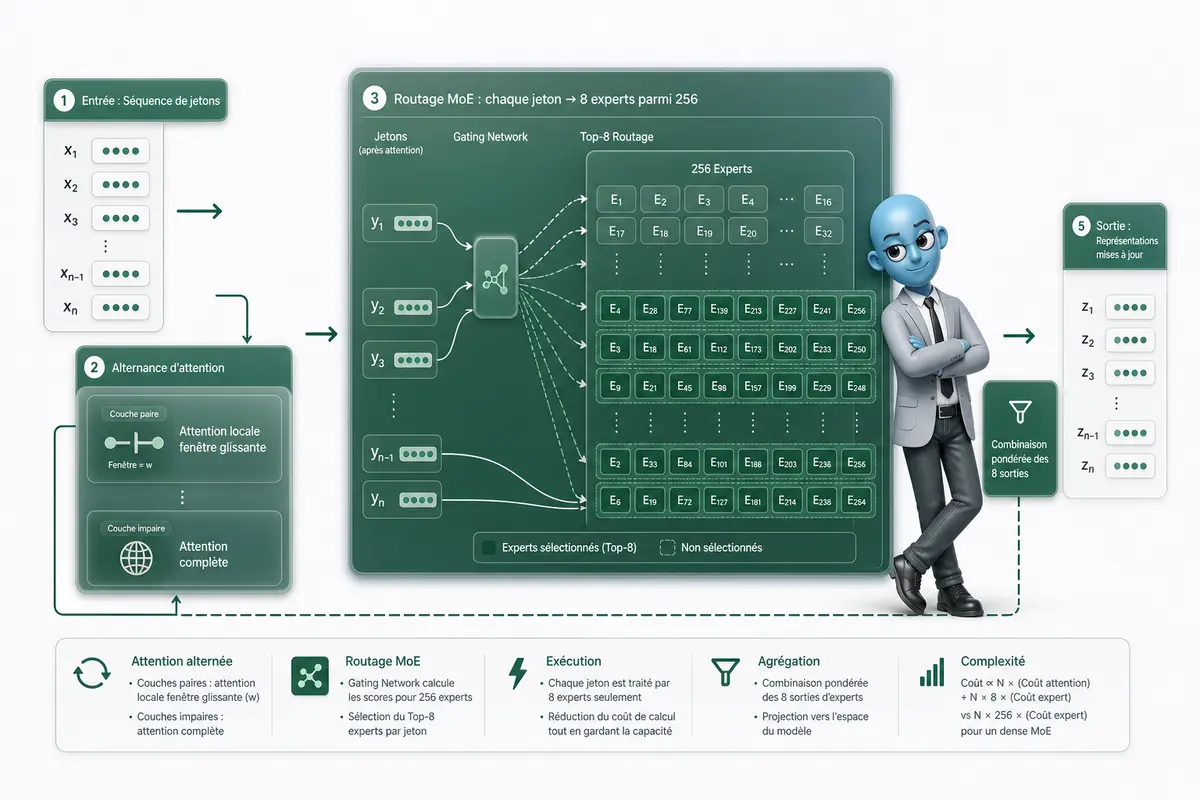
L’attention hybride alterne trois couches à fenêtre glissante et une couche d’attention complète. L’attention à fenêtre glissante traite une portion limitée du contexte autour d’un jeton. L’attention complète peut, elle, prendre en compte l’ensemble du contexte disponible. Cette alternance relie un traitement local à une vision plus large, utile quand un agent de codage doit considérer à la fois des éléments proches dans le texte et des informations éloignées, par exemple dans un contexte long.
IQuest-Q1 utilise aussi du RoPE partiel. RoPE signifie « Rotary Position Embedding », ou encodage positionnel rotatif : c’est une méthode qui représente la position des jetons dans une séquence. Le caractère partiel indique que cette méthode ne s’applique qu’à une partie de la représentation. Avec la prédiction de plusieurs jetons, ce choix vise à limiter les coûts associés au traitement de longs contextes et à accélérer l’inférence, c’est-à-dire la génération de réponses par le modèle. Ce sont des objectifs architecturaux, pas une mesure de résultat.
Pour le codage agentique, l’enjeu est de traiter des échanges et des contextes qui peuvent s’allonger au fil d’une tâche. L’attention hybride, le RoPE partiel et la prédiction de plusieurs jetons s’inscrivent dans cette contrainte de coût. Leur présence ne suffit toutefois pas à établir comment IQuest-Q1 planifie une tâche, utilise des outils ou modifie du code : ces capacités ne se déduisent pas des seuls mécanismes décrits ici.
Comment évaluer ses performances face à DeepSeek-V4 ?
IQuest-Q1 s’évalue face à DeepSeek-V4-Flash et DeepSeek-V4-Pro sur des tâches de codage agentique et de raisonnement. La comparaison porte sur la capacité des modèles à utiliser des outils, à avancer dans un environnement de travail et à résoudre des problèmes qui demandent plusieurs étapes. Elle ne permet pas, à elle seule, de désigner un modèle supérieur.
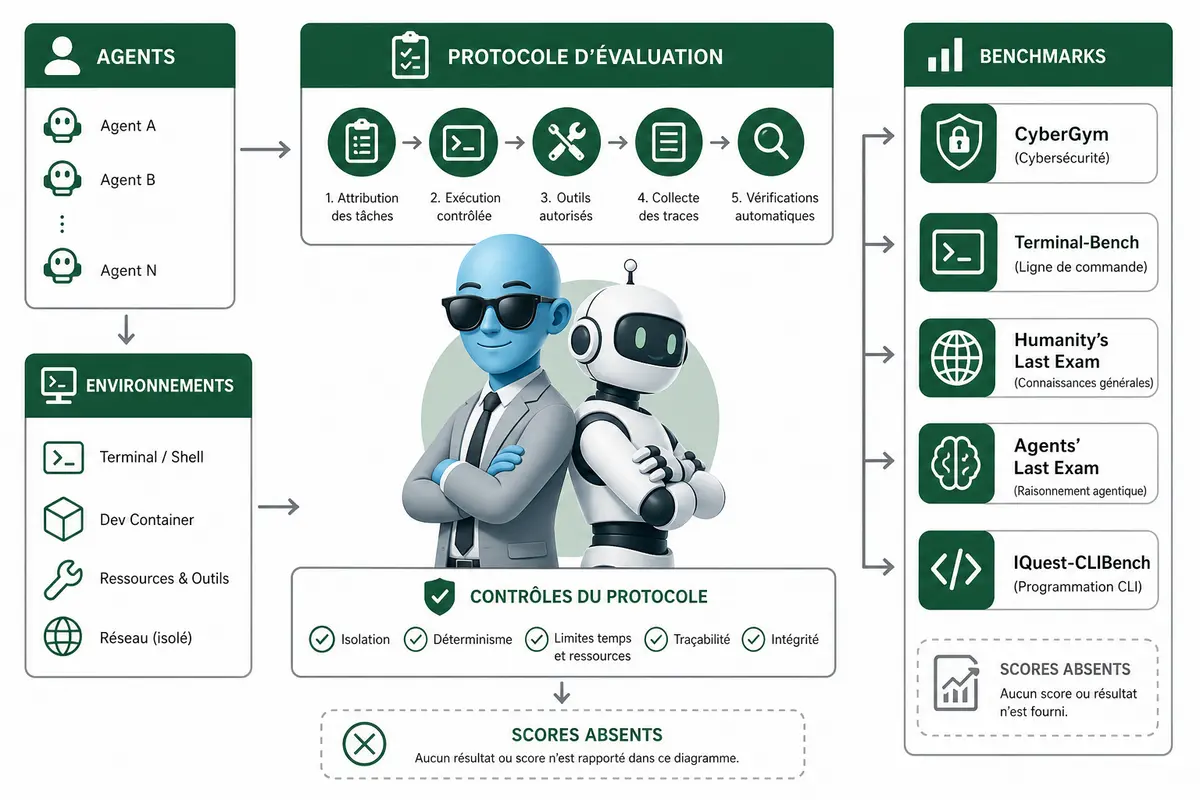
Les benchmarks cités couvrent des tâches différentes : CyberGym évalue des capacités liées à la cybersécurité, tandis que Terminal-Bench 2.1 teste le travail réalisé depuis un terminal. Humanity’s Last Exam et Agents’ Last Exam portent sur des questions exigeantes de connaissances et de raisonnement. IQuest-CLIBench complète ces tests avec des tâches centrées sur l’utilisation de bibliothèques logicielles. Pris ensemble, ces benchmarks donnent des indices sur les capacités des modèles, mais ne résument pas tous les usages réels du codage agentique.
Les évaluations s’appuient sur des agents, c’est-à-dire des systèmes qui peuvent enchaîner des actions et interagir avec des outils plutôt que répondre en un seul message. Les limites de temps sont adaptées aux tâches longues. C’est important : un problème complexe peut nécessiter plusieurs essais, des commandes exécutées dans un terminal ou des ajustements de code. Un test trop court mesurerait surtout la vitesse, pas la capacité à mener la tâche à terme.
Les informations disponibles décrivent donc le protocole et les benchmarks retenus. Elles ne fournissent ni scores chiffrés ni classement entre IQuest-Q1, DeepSeek-V4-Flash et DeepSeek-V4-Pro. Je ne peux pas en déduire qu’un modèle domine les autres. L’absence d’entrées multimodales limite aussi les tâches évaluées : ces tests ne permettent pas de juger comment les modèles traiteraient, par exemple, une image ou une vidéo intégrée à un problème de développement. Il faut distinguer le dispositif d’évaluation, qui est décrit, des résultats comparatifs, qui ne sont pas disponibles.
Comment déployer IQuest-Q1 ?
Je peux déployer IQuest-Q1 avec SGLang ou vLLM, les deux moteurs d’inférence indiqués pour servir le modèle. Des images Docker préconstruites sont aussi mentionnées. Elles peuvent simplifier la mise en place d’un environnement, mais leur existence ne garantit pas qu’une image précise soit disponible, compatible avec votre infrastructure ou prête à l’emploi.
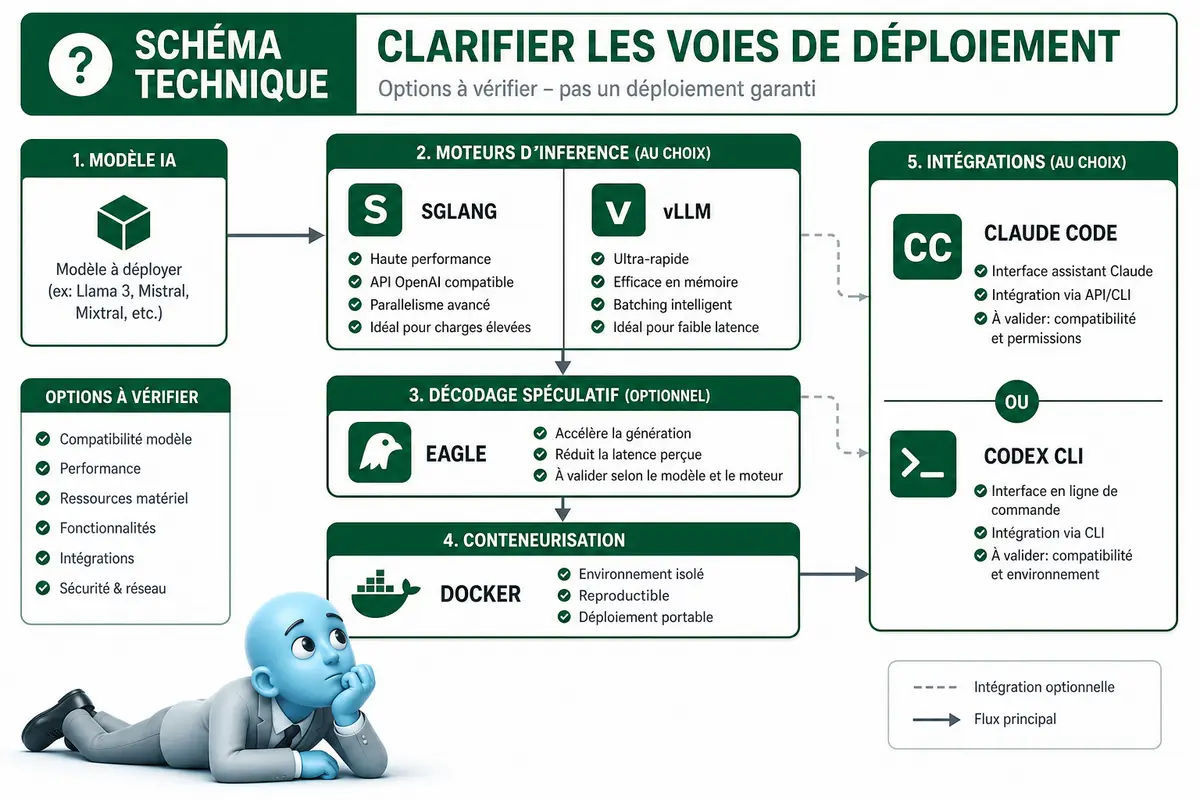
Le décodage spéculatif fondé sur EAGLE est également pris en charge. Cette technique cherche à accélérer la génération en faisant proposer des tokens par un mécanisme auxiliaire, puis en les vérifiant avec le modèle. C’est une option d’exécution, pas une promesse de gain mesuré dans votre contexte. Le résultat dépend notamment du moteur utilisé et des conditions d’exécution ; les détails nécessaires pour les évaluer ne sont pas précisés ici.
IQuest-Q1 est aussi prévu pour s’intégrer à Claude Code et Codex CLI. Ces outils permettent d’utiliser un modèle dans des flux de travail de codage agentique, où l’agent peut notamment produire du code et interagir avec des outils. Cette intégration relève de l’usage du modèle dans un environnement de développement. Elle ne prouve pas, à elle seule, qu’un connecteur prêt à configurer soit disponible ni que chaque fonction de ces outils soit compatible.
Avant de choisir votre environnement, je vérifierais les points qui ne sont pas détaillés : la disponibilité et la version des images Docker, les versions compatibles de SGLang ou vLLM, l’identifiant exact du modèle, les prérequis matériels et les paramètres de configuration. Je validerais aussi la disponibilité d’EAGLE dans la combinaison retenue et les modalités concrètes d’intégration à Claude Code ou Codex CLI. Sans ces informations, les options indiquées dessinent des voies d’exécution, mais ne suffisent pas à confirmer un déploiement prêt à l’emploi.
Que retenir avant de choisir IQuest-Q1 ?
IQuest-Q1 associe une architecture MoE de 320 milliards de paramètres, dont environ 15 milliards sont activés par jeton, à une fenêtre de contexte de 512 000 jetons. Son attention hybride et la prédiction de plusieurs jetons visent à répondre aux contraintes du long contexte et de l’inférence. Le modèle cible le codage agentique, avec des intégrations prévues à Claude Code et Codex CLI, et peut être déployé avec SGLang ou vLLM. Les benchmarks cités ne suffisent pas, à eux seuls, à établir un classement : aucun score n’est fourni ici. Comme le modèle est encore précoce et textuel, évaluez-le sur vos propres tâches. Vous saurez ainsi s’il répond à vos besoins avant d’engager votre équipe.
FAQ
- Combien de paramètres d’IQuest-Q1 sont activés par jeton ?
Environ 15 milliards sur un total d’environ 320 milliards de paramètres. - Quelle est la taille de sa fenêtre de contexte ?
Sa fenêtre de contexte atteint 512 000 jetons. - À quels usages IQuest-Q1 est-il destiné ?
Il est conçu pour le codage agentique, le raisonnement et l’utilisation d’outils en plusieurs étapes. - Quels outils de déploiement sont mentionnés ?
IQuest-Q1 peut être déployé avec SGLang ou vLLM. Des images Docker préconstruites et un décodage spéculatif fondé sur EAGLE sont également mentionnés. - Quelles sont les limites à prendre en compte ?
Le modèle est textuel et encore précoce. Des échecs répétés et des cas limites non résolus restent possibles. Les informations disponibles ne donnent pas de scores permettant d’établir un classement face à DeepSeek-V4.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en data, IA, automatisation No/Low Code et intégration de l’IA en entreprise. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. J’accompagne des entreprises comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football et Texdecor. Je suis disponible pour aider votre entreprise : contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.