
Je le crée en reliant un LLM aux documents vivants de l’entreprise, pas en lui demandant de tout savoir tout seul. Le vrai sujet, c’est la confiance : réponses sourcées, données à jour, coûts maîtrisés, et une adoption meilleure que les vieux intranets.
Pourquoi les intranets bloquent encore ?
Je vois encore beaucoup d’entreprises qui ont “tout documenté”, mais où personne ne trouve la bonne réponse au bon moment. C’est le paradoxe classique des intranets, des portails SharePoint et des dépôts documentaires. L’information existe, oui. Mais elle dort dans des dossiers, des sous-dossiers, des espaces équipes, des PDF, des pages wiki, parfois dans trois outils différents.
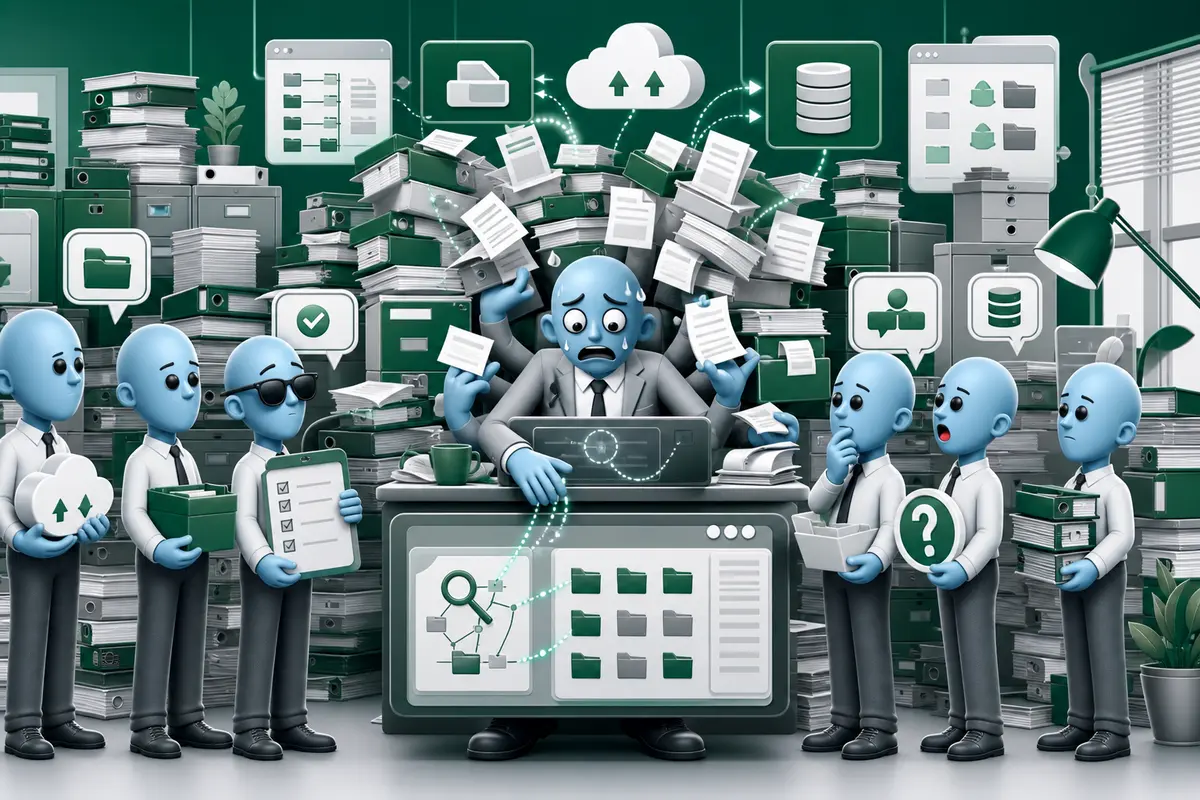
Le problème, ce n’est pas seulement le stockage. C’est la circulation de la connaissance. Un intranet sait ranger. Il sait rarement comprendre le contexte de la personne qui cherche. Un commercial ne formule pas sa question comme un juriste. Un nouveau collaborateur ne connaît pas les bons mots-clés. Un technicien cherche une réponse opérationnelle, pas une procédure de 42 pages mise à jour il y a huit mois.
Dans la vraie vie, ça donne souvent ça :
- Des silos entre métiers, régions, filiales ou équipes projet.
- Une recherche trop lente, qui renvoie trop de résultats ou pas les bons.
- Des documents dupliqués, copiés pour aller plus vite, puis jamais synchronisés.
- Des versions contradictoires, avec personne qui sait vraiment laquelle fait foi.
- Une adoption faible, parce que les équipes ont déjà appris à demander à “la bonne personne” plutôt qu’à chercher.
Chez certains clients, le problème n’est pas le manque de documentation. C’est l’excès de documentation mal reliée au travail réel. Ils ont des bases de connaissances énormes, mais elles ne répondent pas aux questions concrètes du quotidien. Résultat, les équipes contournent le système. Elles envoient un message Teams. Elles ouvrent un ticket. Elles appellent l’expert métier qui sait, parce que lui, au moins, il répond.
Et là, le coût devient invisible mais massif. Du temps perdu à chercher. Des tickets internes répétitifs. Un onboarding lent, parce que les nouveaux doivent reconstruire la carte mentale de l’entreprise. Une dépendance forte à quelques experts, souvent déjà débordés. Le jour où ces personnes partent, une partie de la connaissance part avec elles.
C’est pour ça que l’idée d’un assistant conversationnel paraît séduisante. Poser une question et obtenir une réponse claire, sourcée, contextualisée, c’est exactement ce que les intranets n’ont jamais vraiment réussi à faire. Mais il faut être lucide. Un LLM, c’est-à-dire un grand modèle de langage comme GPT, ne règle pas tout seul le problème. Sans accès fiable aux bonnes sources, il ne fait que parler mieux qu’un moteur de recherche classique.
Pourquoi un LLM seul dérape ?
Un LLM seul, c’est impressionnant, mais ce n’est pas une source de vérité. Il génère la réponse la plus probable à partir de ce qu’il a appris, pas forcément la bonne réponse pour votre entreprise aujourd’hui.
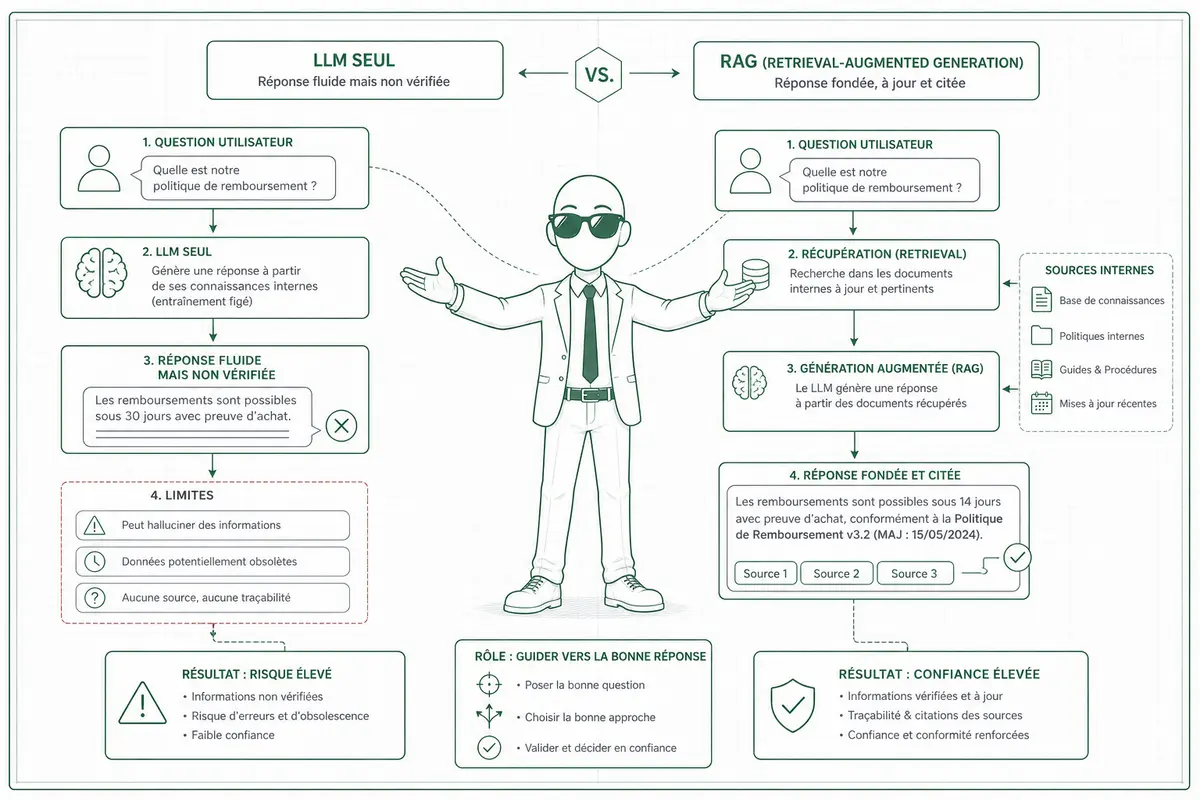
La première limite, ce sont les hallucinations. Le modèle peut produire une réponse très fluide, bien formulée, avec un ton sûr de lui… mais fausse. C’est le piège. Comme la réponse semble crédible, l’utilisateur baisse la garde. J’ai déjà vu ce cas chez un client : le chatbot inventait une règle interne qui ressemblait beaucoup à une vraie procédure, sauf qu’elle n’existait pas.
La deuxième limite, ce sont les données obsolètes. Un LLM ne sait pas automatiquement que votre politique RH a changé hier, qu’un contrat client a été modifié, ou qu’une procédure qualité est passée en version 4. Il ne suit pas vos documents internes en temps réel. Il répond avec sa mémoire, pas avec votre base documentaire vivante.
La troisième limite, c’est le coût du réentraînement. Réentraîner un modèle à chaque mise à jour documentaire, ça paraît propre sur le papier. En pratique, c’est lourd, cher, lent, et rarement tenable. La plupart des entreprises n’ont ni le budget, ni les équipes, ni le cycle de validation pour faire ça toutes les semaines.
Prenez une banque. Si un chatbot donne deux réponses différentes sur une règle de conformité, ou s’il cite une ancienne procédure réglementaire, le sujet dépasse largement la technique. Il y a un risque juridique, un risque opérationnel, et un vrai risque réputationnel. Un mauvais conseil peut déclencher une erreur côté conseiller, une mauvaise information client, ou un problème lors d’un audit.
| Limite | Hallucinations, connaissances obsolètes, réentraînement trop coûteux. |
| Conséquence business | Réponses incohérentes, risques de conformité, perte de confiance. |
| Solution attendue | Connecter le modèle aux sources documentaires réelles et vérifiées. |
C’est là que le RAG devient plus adapté. Le principe est simple : au lieu de laisser le modèle répondre uniquement avec sa mémoire, on l’oblige à s’appuyer sur des sources réelles, à jour, et contrôlées par l’entreprise.
Comment fonctionne un chatbot RAG ?
Quand je parle de RAG en entreprise, j’aime bien casser une idée reçue tout de suite. Ce n’est pas un cerveau magique qui sait tout. C’est plutôt une carte de bibliothèque intelligente. Elle ne répond pas directement de mémoire, elle retrouve d’abord les bons rayons, les bons documents, parfois même les bons paragraphes, puis elle demande au modèle de langage de formuler une réponse propre à partir de ça.
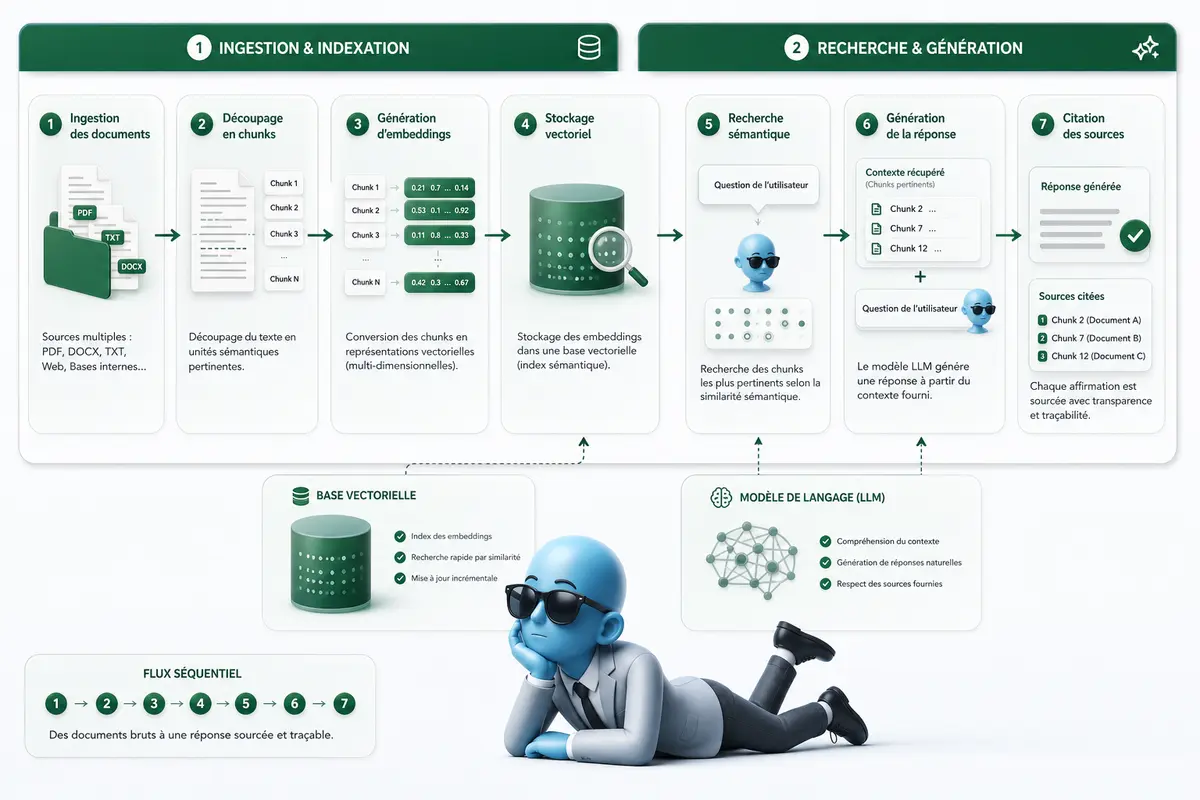
RAG veut dire Retrieval Augmented Generation, ou génération augmentée par récupération. Le principe est simple : avant de générer une réponse, le chatbot va chercher de l’information fiable dans vos contenus internes. Vos procédures, contrats, FAQ, tickets support, bases de connaissance, comptes rendus, tout ce qui peut servir de référence.
Le flux ressemble généralement à ça :
- Ingestion des documents : Le système récupère les fichiers depuis SharePoint, Notion, Google Drive, Confluence, un CRM ou une base interne.
- Découpage en chunks : Les documents sont coupés en petits blocs de texte. Un chunk, c’est juste un morceau exploitable, ni trop court, ni trop long.
- Création des embeddings : Chaque chunk est transformé en vecteur numérique. Ça permet de comparer le sens des textes, pas seulement les mots exacts.
- Index vectoriel : Ces vecteurs sont stockés dans une base spécialisée, faite pour retrouver rapidement les contenus proches d’une question.
- Recherche sémantique : Quand vous posez une question, le système cherche les passages qui veulent dire la même chose, même si les mots sont différents.
- Construction du contexte : Les meilleurs passages sont envoyés au LLM avec la question.
- Génération de la réponse : Le LLM répond en s’appuyant sur ce contexte, pas sur une improvisation.
- Citation des sources : Le chatbot peut indiquer quels documents ont servi à produire la réponse.
C’est là que le RAG devient intéressant en entreprise. Il réduit les hallucinations, parce que le modèle est cadré par des sources concrètes. Il améliore aussi l’auditabilité, parce qu’on peut vérifier d’où vient une réponse. Et pour la conformité, c’est souvent décisif. Dans certains métiers, une réponse doit être justifiable, pas juste plausible.
Mais je préfère être clair. Le RAG ne transforme pas une documentation bancale en vérité absolue. Si vos documents sont obsolètes, contradictoires, mal nommés ou remplis de doublons, le chatbot va le refléter. J’ai déjà vu des projets bloqués non pas par l’IA, mais par la qualité documentaire. Un projet RAG, c’est aussi un projet de gouvernance documentaire.
La bonne nouvelle, c’est que cette approche coûte souvent beaucoup moins cher qu’un réentraînement de modèle. Elle donne des réponses plus fiables, plus fraîches, et surtout vérifiables. Pour une entreprise, c’est généralement le bon compromis entre puissance, contrôle et pragmatisme.
Comment le construire avec Databricks ?
Je le construis dans Databricks quand je veux éviter le RAG éclaté entre 5 outils. Les documents restent dans Delta Lake, les chunks aussi, les embeddings aussi si besoin, l’index vectoriel est dans Vector Search, le modèle est appelé via un endpoint de serving, et je garde les traces dans une table d’audit. C’est simple à opérer, et surtout c’est vérifiable.
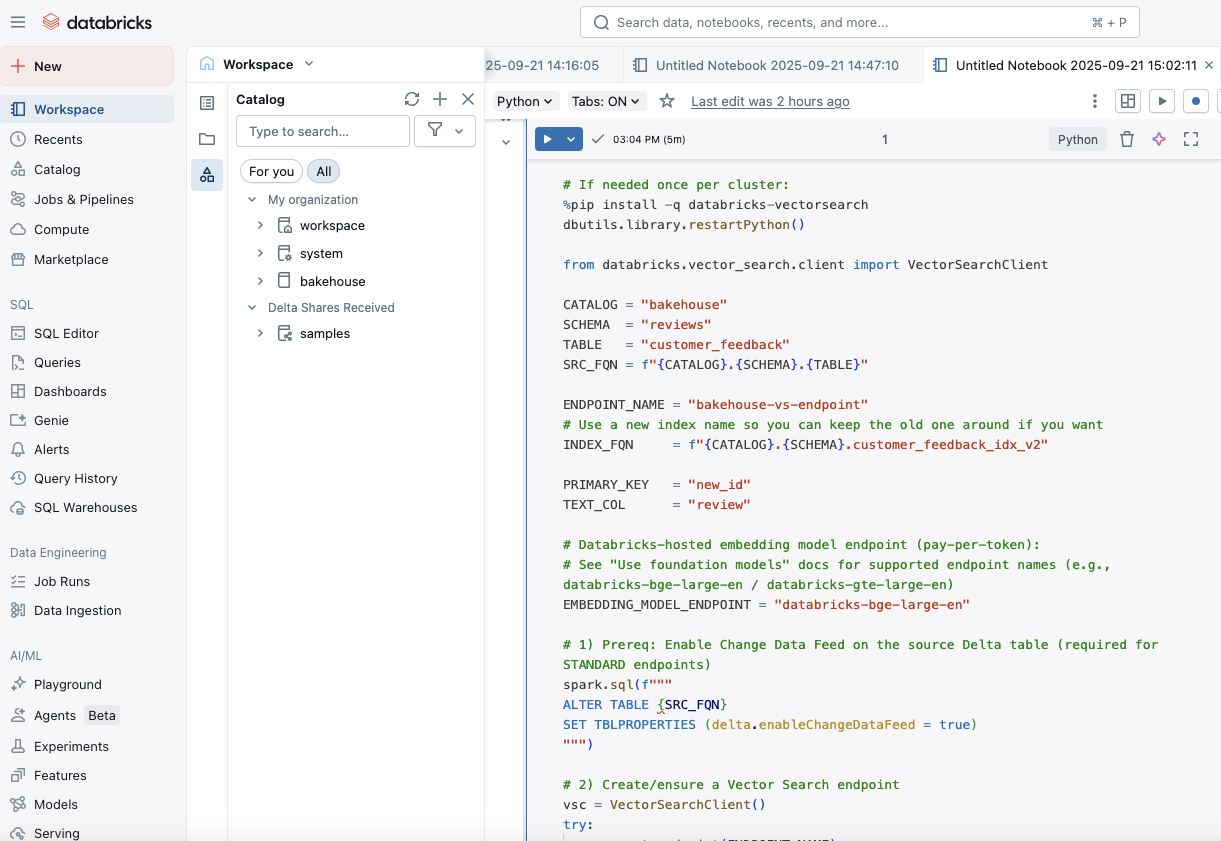
Je pars d’une table de documents internes, par exemple catalog.schema.documents_raw, puis je nettoie et je découpe avec Spark. Le chunking, c’est juste le fait de couper un document en passages assez courts pour être retrouvés puis donnés au modèle.
from pyspark.sql import functions as F

# Je lis les documents internes déjà déposés dans Delta Lake
docs = spark.table("catalog.schema.documents_raw")

# Je nettoie le texte et je découpe par blocs simples
# En production, j'adapte souvent le découpage par type de document
chunks = (
    docs
    .select(
        "doc_id",
        "source",
        "updated_at",
        F.regexp_replace(F.col("content"), r"s+", " ").alias("clean_text")
    )
    .select(
        "doc_id",
        "source",
        "updated_at",
        F.posexplode(F.split(F.col("clean_text"), r"(?<=. )")).alias("chunk_id", "chunk_text")
    )
    .filter(F.length("chunk_text") > 200)
)

# Je stocke les passages dans une table Delta
chunks.write.mode("overwrite").option("overwriteSchema", "true").saveAsTable(
    "catalog.schema.documents_chunks"
)
Pour les embeddings, c’est-à-dire les vecteurs numériques qui représentent le sens du texte, je peux les laisser gérer par Vector Search avec un index Delta Sync. Si je veux les stocker moi-même, je peux aussi appeler un endpoint d’embedding. Le nom de l’endpoint dépend de votre environnement.
from mlflow.deployments import get_deploy_client

client = get_deploy_client("databricks")

# Exemple simple pour générer des embeddings sur un petit lot
# Pour un gros volume, je le fais en batch distribué
pdf = spark.table("catalog.schema.documents_chunks").limit(100).toPandas()

response = client.predict(
    endpoint="embedding_endpoint",
    inputs={"input": pdf["chunk_text"].tolist()}
)

pdf["embedding"] = [item["embedding"] for item in response["data"]]

spark.createDataFrame(pdf).write.mode("overwrite").option("mergeSchema", "true").saveAsTable(
    "catalog.schema.documents_chunks"
)
Une fois l’index Vector Search créé sur catalog.schema.documents_chunks, je cherche les passages utiles, je construis le contexte, puis je prépare le prompt. Le prompt force le modèle à répondre uniquement avec les sources trouvées.
from databricks.vector_search.client import VectorSearchClient

question = "Quelle est la procédure de conformité à appliquer ?"

vsc = VectorSearchClient()
index = vsc.get_index(
    endpoint_name="rag_endpoint",
    index_name="catalog.schema.docs_index"
)

results = index.similarity_search(
    query_text=question,
    columns=["chunk_text", "source", "updated_at"],
    num_results=5
)

rows = results["result"]["data_array"]

context = "nn".join([row[0] for row in rows])

sources = [
    {
        "source": row[1],
        "updated_at": str(row[2])
    }
    for row in rows
]

system_prompt = (
    "Réponds uniquement avec le contexte fourni. "
    "Si le contexte ne suffit pas, dis-le clairement. "
    "Cite les sources."
)

user_prompt = f"Contexte :n{context}nnQuestion : {question}"
Ensuite j’appelle le modèle via un endpoint de serving Databricks. Ici rag_endpoint est un nom générique, chez un client ce sera souvent un endpoint différent pour le LLM et pour Vector Search.
from databricks.sdk import WorkspaceClient
from datetime import datetime
import uuid

w = WorkspaceClient()

# J'appelle le modèle hébergé derrière un endpoint Databricks Serving
response = w.serving_endpoints.query(
    name="rag_endpoint",
    messages=[
        {"role": "system", "content": system_prompt},
        {"role": "user", "content": user_prompt}
    ],
    max_tokens=700,
    temperature=0.1
)

answer = response.choices[0].message.content

final_response = {
    "answer": answer,
    "sources": sources
}

# Je journalise pour audit : question, réponse, sources et date
audit_row = [(
    str(uuid.uuid4()),
    question,
    answer,
    sources,
    datetime.utcnow().isoformat()
)]

spark.createDataFrame(
    audit_row,
    schema="request_id string, question string, answer string, sources array<map<string,string>>, created_at string"
).write.mode("append").saveAsTable("catalog.schema.rag_audit_logs")

final_response
Les points que je ne saute jamais, même sur un premier POC :
- Droits d’accès : Un utilisateur ne doit jamais récupérer un document qu’il n’a pas le droit de lire.
- Fraîcheur des documents : Les index doivent être resynchronisés quand les sources changent.
- Logs : Je garde question, réponse, sources, scores et version du prompt.
- Tests de non-réponse : Le bot doit savoir dire “je ne sais pas”.
- Citations : Chaque réponse métier doit pointer vers ses sources.
- Monitoring : Je surveille les hallucinations, les mauvaises sources et les questions sans réponse.
Quels cas d’usage rapportent vite ?
Les cas d’usage qui rapportent vite, je les vois presque toujours au même endroit : là où les équipes cherchent des réponses dans des documents dispersés, mal connus, parfois à jour, parfois pas. Un chatbot RAG devient intéressant quand il évite à quelqu’un d’ouvrir 8 PDF, 3 outils internes et un vieux mail pour répondre à une question simple.
- Automobile. Les concessions, le service client, la conformité et le support technique sont de bons candidats. Un agent peut demander quelle procédure appliquer pour une garantie, quelle règle commerciale suivre, ou comment diagnostiquer une panne connue. Le chatbot ne remplace pas l’expert, mais il réduit les tickets répétitifs et aide les équipes à répondre plus vite, surtout les nouveaux arrivants.
- Ingénierie. Le vrai sujet, c’est la version des documents. Entre le PLM, c’est-à-dire l’outil qui gère le cycle de vie produit, les fichiers CAD/CAM, donc conception et fabrication assistées par ordinateur, et les ordres de modification, on peut vite se tromper de référence. Un RAG bien connecté peut aider à retrouver la bonne version, expliquer une modification, ou pointer vers la source validée.
- Fabrication. Sur le terrain, la valeur vient de l’accès rapide aux consignes de sécurité, aux procédures de maintenance et aux modes opératoires. Quand une ligne s’arrête, personne n’a envie de fouiller un SharePoint. Si l’opérateur obtient la bonne procédure en quelques secondes, on réduit les arrêts inutiles, les erreurs et parfois les risques d’accident.
Les bénéfices sont très opérationnels. Onboarding plus rapide, meilleure autonomie des agents, moins de dépendance aux experts internes, résolution automatique d’une partie des demandes simples, baisse des sollicitations répétitives. Je reste prudent sur les chiffres, parce que sans mesure interne, annoncer un pourcentage est souvent du marketing. Ce qui compte, c’est de mesurer avant/après : volume de tickets, temps moyen de réponse, taux d’escalade, satisfaction utilisateur.
| Cas d’usage | Utilisateurs | Valeur attendue | Risque à surveiller |
| Assistance concessions automobile | Conseillers, vendeurs, après-vente | Réponses plus rapides, moins d’escalades, meilleure cohérence | Documents commerciaux ou garanties non à jour |
| Support technique automobile | Techniciens, agents support | Diagnostic plus rapide, tickets répétitifs réduits | Confusion entre recommandations et procédures obligatoires |
| Documentation ingénierie | Ingénieurs, chefs de projet, qualité | Accès à la bonne version, moins d’erreurs de référence | Mauvaise gouvernance des versions PLM ou CAD/CAM |
| Procédures de fabrication | Opérateurs, maintenance, HSE | Moins d’arrêts, meilleur respect sécurité, autonomie terrain | Procédures critiques mal validées ou ambiguës |
Je commencerais toujours par un périmètre documentaire étroit, bien gouverné, avant d’étendre le chatbot à toute l’entreprise.
Et si votre knowledge base devenait enfin utile ?
Un chatbot RAG en entreprise, ce n’est pas juste un LLM branché sur trois PDF. C’est une façon plus fiable de transformer les documents internes en réponses utiles, traçables et à jour. Les intranets ont souvent créé du stockage, pas de l’usage. Les LLM seuls peuvent halluciner, répondre avec des informations dépassées ou coûter trop cher à maintenir. Le RAG remet les sources au centre. Avec une plateforme comme Databricks, on peut industrialiser l’ingestion, la recherche, les réponses et les traces. Le bénéfice pour vous est simple : moins de temps perdu, moins de tickets répétitifs, plus de confiance dans les réponses.
FAQ
- Qu’est-ce qu’un chatbot RAG en entreprise ?
C’est un assistant IA qui va chercher des informations dans les documents internes avant de répondre. Il ne se contente pas de générer du texte. Il s’appuie sur des sources réelles, ce qui rend les réponses plus fiables et plus faciles à vérifier. - Pourquoi ne pas utiliser seulement un LLM ?
Un LLM seul peut halluciner, utiliser des connaissances dépassées ou donner une réponse incohérente avec vos règles internes. En entreprise, ce n’est pas un détail. Sur des sujets conformité, support technique ou procédures métier, il faut pouvoir retrouver la source. - Le RAG remplace-t-il un intranet ou SharePoint ?
Pas forcément. Le RAG peut se connecter aux contenus existants et les rendre plus utilisables. L’idée n’est pas toujours de remplacer le stockage documentaire, mais de créer une couche conversationnelle capable de retrouver les bons passages au bon moment. - Quels documents faut-il connecter en premier ?
Je commencerais par un périmètre étroit et utile : procédures support, documentation technique, règles conformité, guides d’onboarding ou consignes de sécurité. Le bon point de départ, c’est un ensemble de documents souvent consultés, mais difficiles à retrouver rapidement. - Comment mesurer la valeur d’un chatbot RAG ?
On peut suivre le temps gagné, la baisse des tickets répétitifs, le taux de résolution automatique, la satisfaction des utilisateurs et la qualité des réponses sourcées. Je conseille aussi de mesurer les cas où le chatbot refuse de répondre faute de contexte, car c’est un bon signal de contrôle.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. J’accompagne des équipes qui veulent rendre leurs données vraiment exploitables, pas juste les stocker quelque part. J’ai travaillé avec des clients comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Je dirige l’agence webAnalyste et l’organisme Formations Analytics. Si vous voulez structurer un projet RAG, IA ou data proprement dans votre business, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.