
Je choisis les skills qui obligent l’IA à comprendre, planifier, tester et sécuriser avant de coder. Claude Code et Codex CLI deviennent vraiment utiles quand on leur donne du contexte propre, un objectif vérifiable et des garde-fous simples.
Pourquoi une skill change tout ?
Une skill change tout parce qu’elle transforme une demande vague en mode opératoire réutilisable. Avec Claude Code ou Codex CLI, le sujet n’est pas d’avoir une réponse rapide. Le vrai sujet, c’est de guider l’agent avec assez de contexte pour qu’il produise une action utile dans votre code, vos fichiers, vos contraintes.
Ces outils travaillent dans le terminal. Ils peuvent analyser un projet, lire des fichiers, proposer ou appliquer des modifications, exécuter des commandes selon les permissions données, et aider à itérer sur du code. Mais ils ne devinent pas votre intention métier. Ils suivent ce que vous leur donnez. Si le cadre est flou, le résultat sera souvent moyen, même avec un très bon modèle.
Je fais une vraie différence entre trois choses.
- Un prompt jetable sert à demander quelque chose une fois. C’est pratique pour une question rapide, mais ça disparaît avec le contexte.
- Une instruction projet décrit les règles générales du repo. Style de code, commandes de test, conventions, architecture, choses à éviter.
- Une skill réutilisable décrit une façon de travailler sur un type de tâche. Elle dit quoi faire, dans quel périmètre, avec quel résultat attendu, et comment vérifier que c’est bon.
Une bonne skill évite le “Fais-moi ça proprement”. Parce que “proprement”, ça ne veut rien dire si on ne précise pas le cadre. Elle clarifie le besoin, limite le périmètre, définit le livrable attendu, puis prévoit une validation. Validation simple parfois, comme lancer les tests. Validation plus métier parfois, comme vérifier qu’un endpoint garde le même contrat de réponse.
J’ai vu ça chez plusieurs clients. Le problème vient rarement du modèle. Il vient surtout du flou donné au modèle. On demande une refonte, mais sans dire ce qui ne doit pas bouger. On demande une optimisation, mais sans métrique. On demande une correction, mais sans scénario de reproduction. L’agent fait alors au mieux, et “au mieux” n’est pas une stratégie.
| Situation | Mauvaise approche | Meilleure skill à utiliser |
| Corriger un bug | “Trouve le problème et corrige.” | Skill de debug avec reproduction, fichiers concernés, hypothèses, correction minimale et test de non-régression. |
| Refactorer un module | “Rends le code plus propre.” | Skill de refactoring avec périmètre limité, comportement inchangé, conventions projet et validation par tests. |
| Ajouter une fonctionnalité | “Ajoute cette feature.” | Skill d’implémentation avec besoin utilisateur, contrat attendu, fichiers à modifier, cas limites et commande de validation. |
Comment cadrer le besoin avant de coder ?
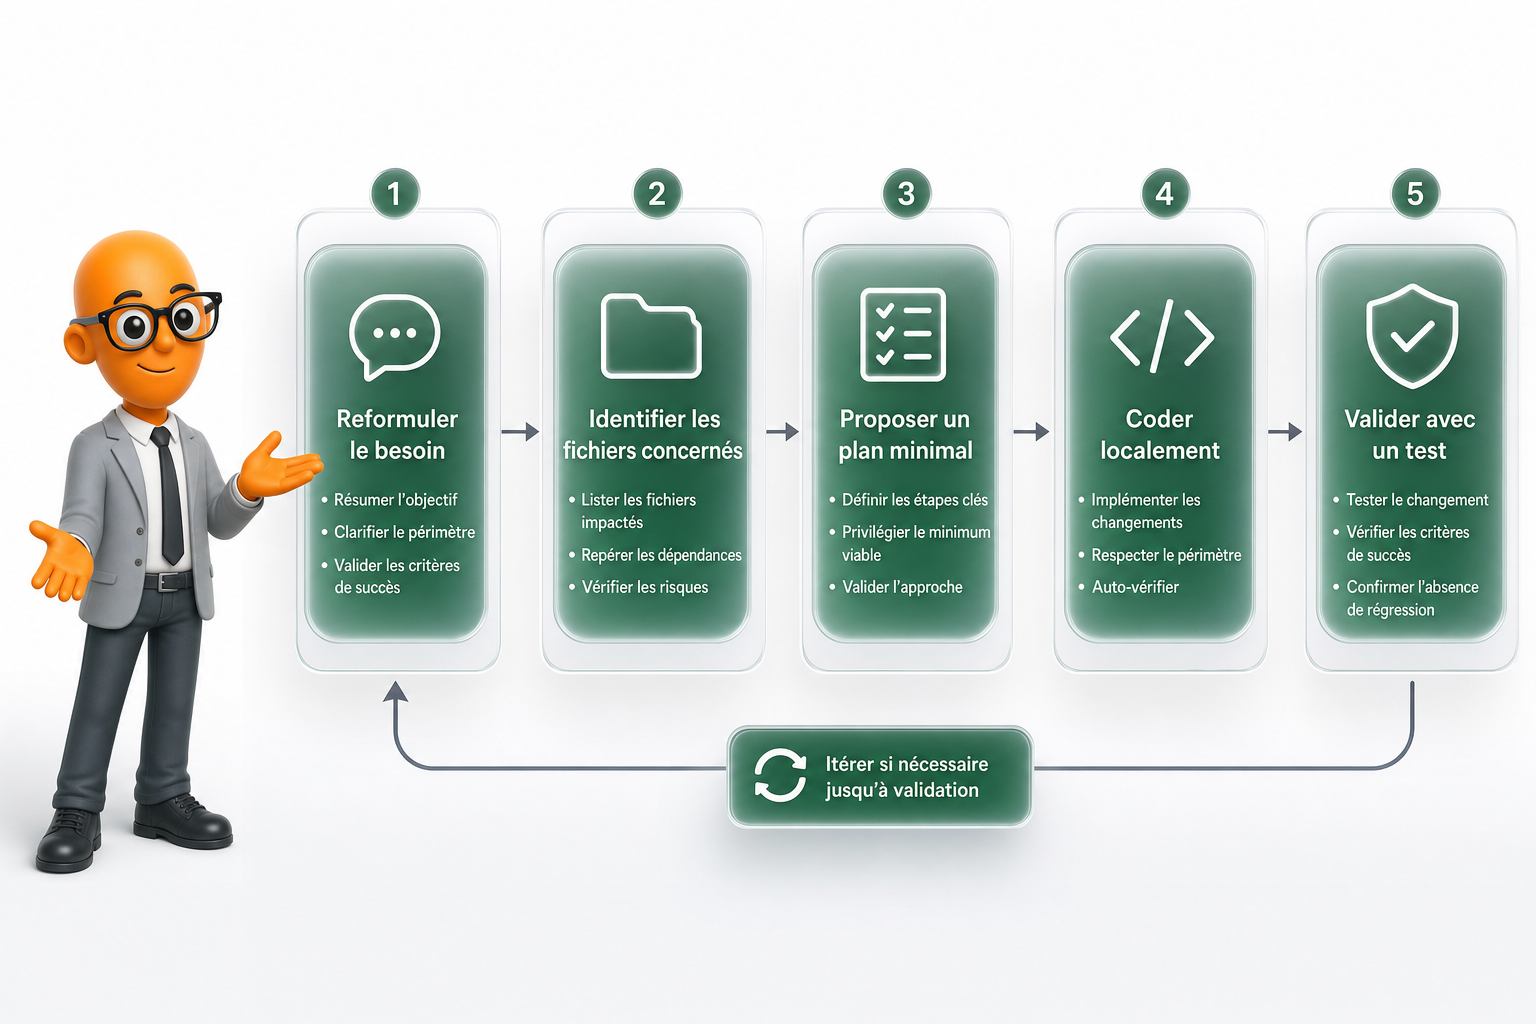
Je cadre le besoin avant de coder en obligeant l’agent à ralentir. Pas à produire plus de texte. À vérifier qu’il a compris, à isoler les fichiers utiles, à proposer un petit plan, puis à coder avec des tests. C’est la skill que je mets presque toujours dans Claude Code ou Codex CLI, parce qu’une demande floue finit vite en refonte sauvage.
Exemple réel assez classique : “Corrige le bug sur les coupons expirés”. Dit comme ça, l’agent peut toucher au panier, au paiement, à l’API, à la base. L’objectif vérifiable serait plutôt : “Quand un coupon est expiré, l’API doit retourner une erreur explicite et le total ne doit pas être recalculé avec la remise”. Là, on peut tester.
Voici un contenu prêt à copier dans un fichier SKILL.md, si votre environnement supporte ce format. La même logique marche aussi dans CLAUDE.md, AGENTS.md ou dans une instruction projet selon l’outil.
Skill: Cadrage avant modification

Avant de modifier le code, tu dois reformuler le besoin en une phrase vérifiable.

Tu dois poser des questions si une règle métier, un comportement attendu ou un cas limite est ambigu.

Tu dois lister les fichiers probablement concernés, sans ouvrir toute l’application inutilement.

Tu dois proposer un plan minimal en 3 à 5 points maximum.

Tu ne dois pas réécrire une fonctionnalité complète si une correction locale suffit.

Tu dois écrire ou mettre à jour les tests liés au changement.

Tu dois exécuter les tests disponibles quand c’est possible.

Tu dois résumer les changements avec les fichiers modifiés, les tests lancés et les limites restantes.
Sur notre exemple de coupon, j’attends que l’agent demande au moins : “Un coupon expire à quelle heure et dans quel fuseau ?”, “L’erreur attendue existe déjà ?”, “Le front doit afficher un message précis ?”. C’est pénible deux minutes, mais ça évite une correction qui casse les coupons valides. J’ai vu ça chez un client, l’IA avait “simplifié” la logique promo complète pour régler un seul cas.
Pour les tests, je donne des commandes prudentes. L’agent doit choisir selon le projet, pas tout lancer au hasard sur un monorepo énorme.
# JavaScript, selon le gestionnaire utilisé
npm test
npm run test
pnpm test
yarn test

# Python, selon la stack du projet
pytest
python -m pytest
python manage.py test
Ma checklist courte :
- Le besoin est reformulé en comportement observable.
- Les zones du code touchées sont limitées.
- Le plan tient en quelques lignes.
- Un test prouve la correction.
- Les tests disponibles ont été lancés ou l’impossibilité est expliquée.
- L’agent n’a pas réécrit l’application sans raison.
Quand utiliser un agent harness ?
Un agent harness devient utile quand je ne veux plus demander à un seul agent de tout faire. Dès qu’une équipe veut séparer les rôles, cadrer les responsabilités et éviter l’agent “magique” qui code, relit, corrige et valide tout seul, le harness prend du sens.
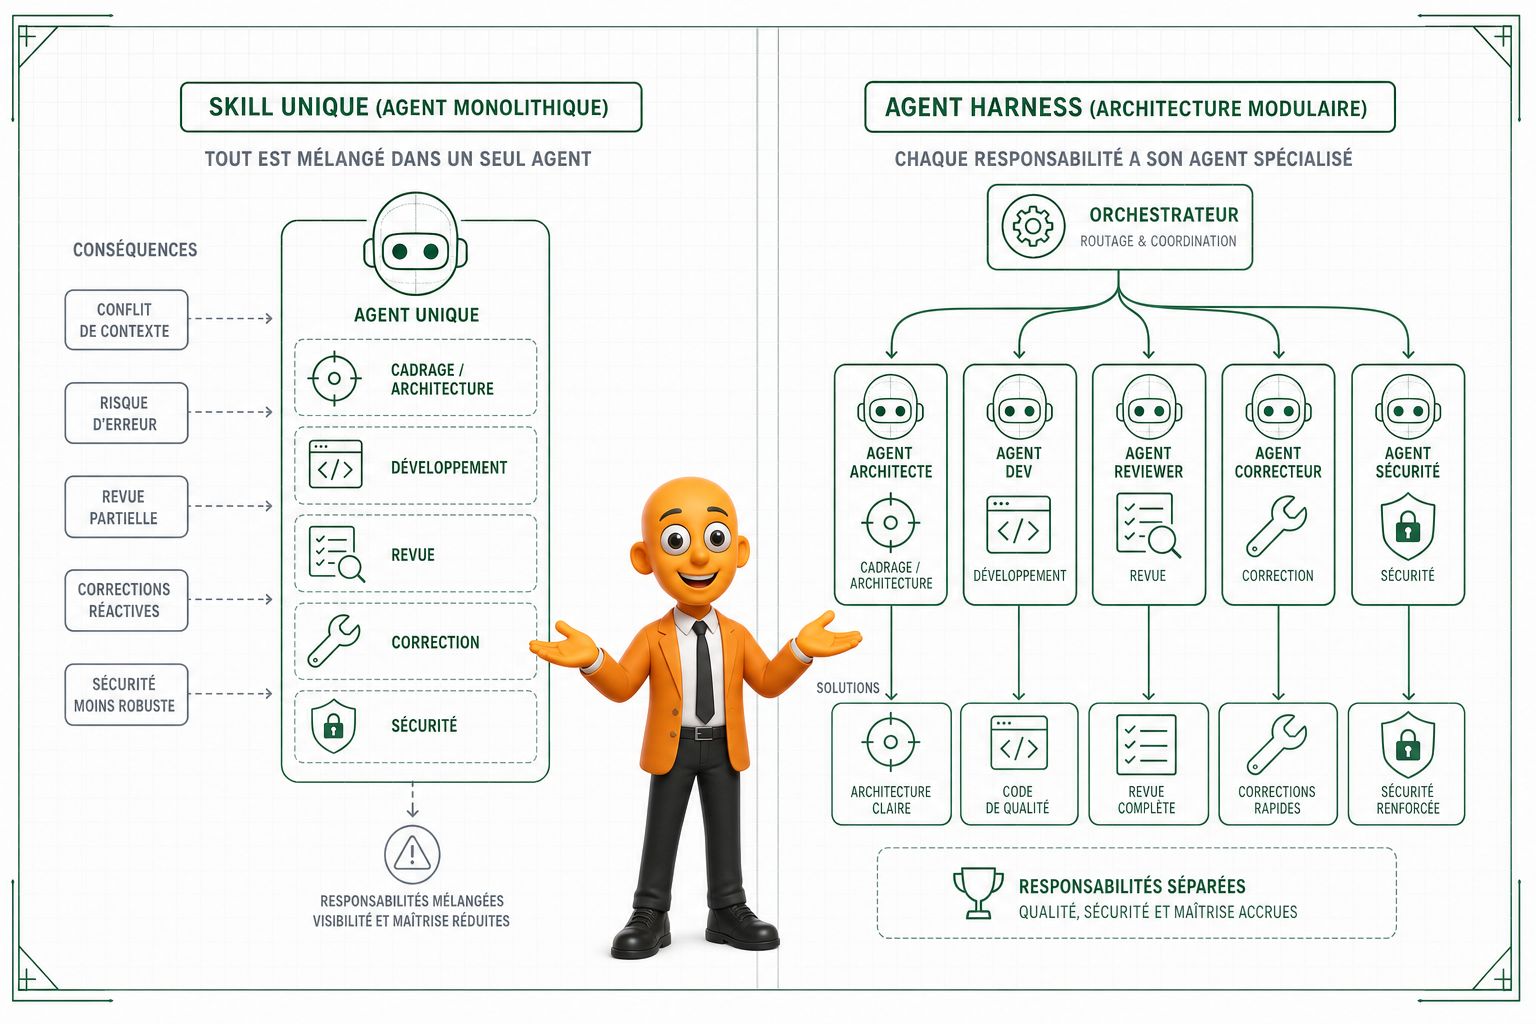
Le mot peut sembler lourd, mais l’idée est simple. Un agent harness, c’est une petite organisation d’agents avec des missions séparées. Dans le bundle dont je parlais, j’aurais typiquement un agent architecte, un développeur, un reviewer, un correcteur et un scanner de sécurité. Chacun a son périmètre. L’architecte propose le découpage. Le développeur implémente. Le reviewer cherche les problèmes. Le correcteur applique les changements. Le scanner sécurité vérifie les risques connus, surtout ceux qu’on retrouve dans les guides comme OWASP, qui liste les grandes familles de failles applicatives.
Le flux reste très terre à terre. Je cadre le besoin, l’architecte propose une approche, le développeur code, le reviewer relit, le correcteur ajuste, puis l’agent sécurité vérifie les points sensibles. Ce n’est pas une usine autonome. C’est surtout une façon de réduire les angles morts. Chez un client, on avait arrêté de demander “fais-moi la feature complète”. On demandait plutôt “propose l’impact”, puis “implémente uniquement ce fichier”, puis “relis sans modifier”. Les résultats étaient beaucoup plus propres.
Pour organiser ça dans un repo, je préfère séparer les instructions. C’est plus lisible, et surtout plus facile à maintenir quand l’équipe grandit.
agents/
  architecte.md
  developpeur.md
  reviewer.md
  correcteur.md
  securite.md

skills/
  conventions-code.md
  tests.md
  api-contracts.md

docs/
  architecture.md
  decisions.md
Le prompt de revue doit être étroit. Il ne doit pas demander à l’agent de tout réécrire. Il doit lui demander de signaler. C’est là que ça marche le mieux.
Tu es reviewer de code.

Analyse uniquement les changements fournis.

Signale :
- Les risques techniques.
- Les régressions probables.
- Les tests manquants.
- Les changements trop larges ou hors scope.
- Les points de sécurité applicative à vérifier, en t’appuyant sur les bonnes pratiques reconnues comme OWASP quand c’est pertinent.

Ne modifie pas le code.
Ne propose pas une refonte complète.
Donne une liste courte, priorisée, avec le fichier concerné quand c’est possible.
Plus la mission est étroite, meilleur est le résultat. Un agent qui “fait tout” finit souvent par mélanger les niveaux de décision. Un agent reviewer qui ne fait que reviewer devient beaucoup plus utile.
| Approche | Quand je l’utilise | Limite principale |
| Skill unique | Pour une tâche simple, répétable, avec peu d’ambiguïté. | L’agent peut mélanger conception, code et validation. |
| Agent harness | Pour un flux d’équipe avec cadrage, implémentation, revue, correction et sécurité. | Ça demande plus de discipline et des instructions bien séparées. |
Comment garder un code simple ?
Je garde un code simple en donnant à l’agent une consigne très stricte : comprendre avant d’écrire, réduire avant d’ajouter, prouver avant de livrer.
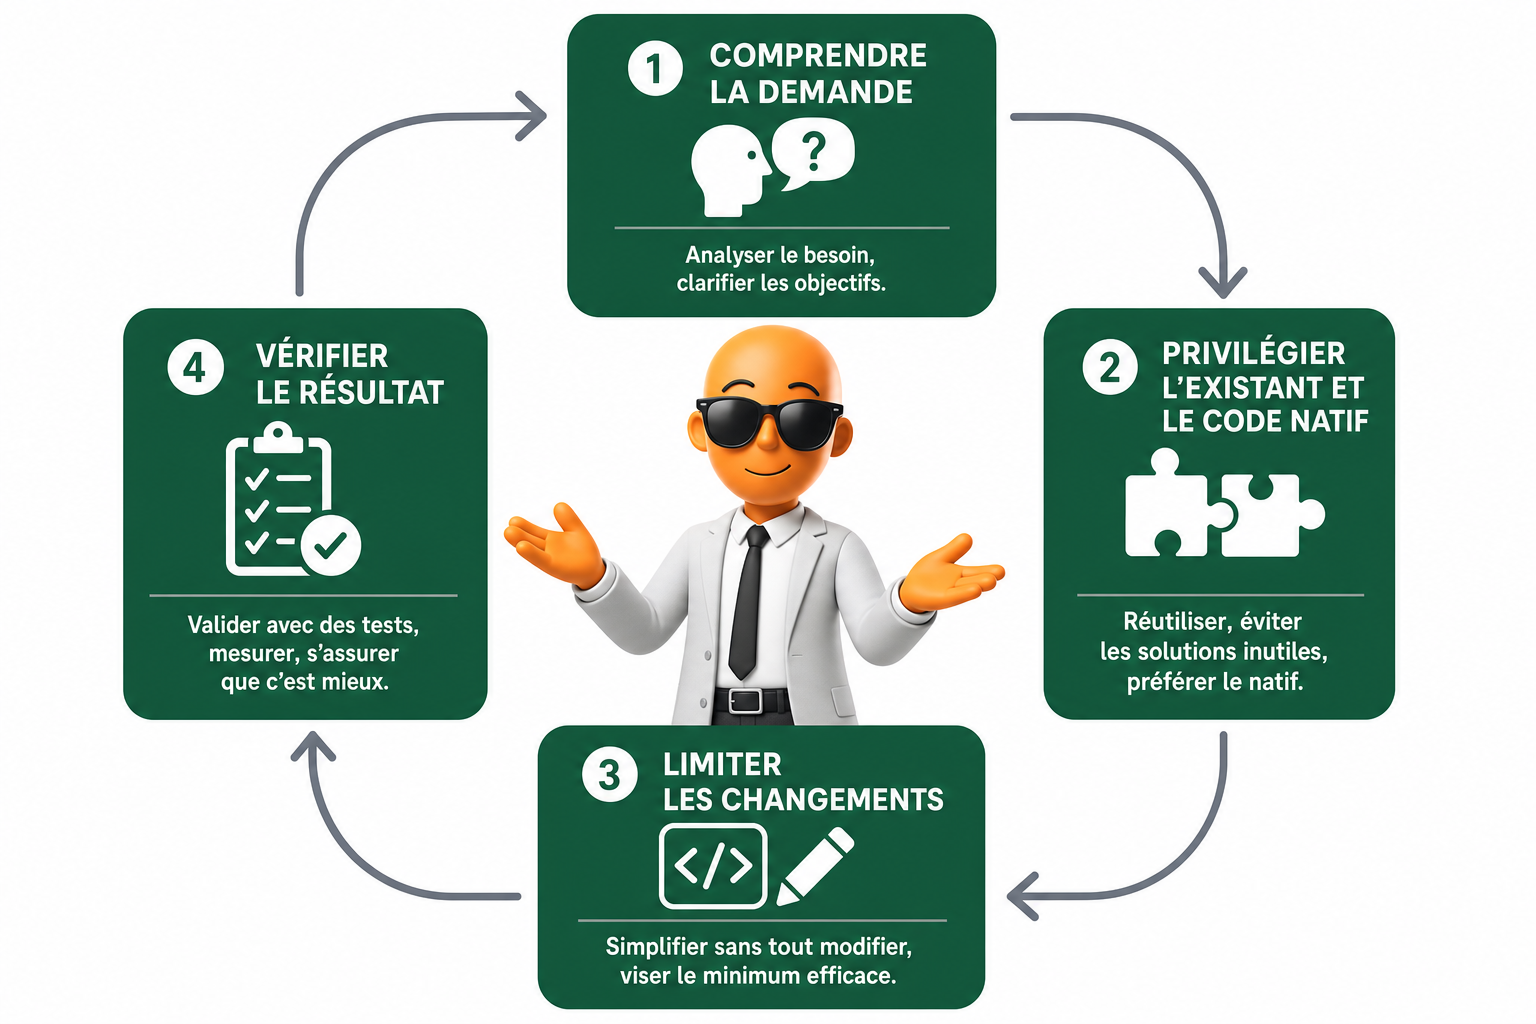
La skill que j’utilise s’inspire d’une approche souvent associée aux bons usages des agents de code, notamment dans l’esprit des recommandations d’Andrej Karpathy : l’agent ne doit pas foncer tête baissée. Il doit poser une question si l’objectif est flou, proposer le changement le plus petit possible, toucher uniquement les fichiers nécessaires, et viser un résultat vérifiable. Pas “j’ai tout réorganisé parce que c’était mieux”. Non. On veut une amélioration claire, testable, et facile à relire.
Skill simplicité : Si la demande est ambiguë, pose une question avant de coder. Cherche d’abord la solution la plus simple. Ne modifie que l’essentiel. Évite les abstractions inutiles. Termine avec un objectif vérifiable : test qui passe, bug reproduit puis corrigé, comportement confirmé sur un vrai cas.
J’ajoute souvent une deuxième skill, très pratique avec Claude Code ou Codex CLI : générer du code plus court en utilisant ce que le langage ou le framework fournit déjà. Beaucoup de projets traînent des dépendances juste pour faire trois lignes de logique. Ça finit par coûter cher en maintenance.
Skill code court : Avant d’ajouter une dépendance, vérifie si le langage, la librairie standard ou le framework sait déjà faire. Remplace une logique longue par une fonction native quand c’est raisonnable. Ne sacrifie jamais la lisibilité, la sécurité ou les performances juste pour faire court.
Exemple JavaScript, quand une dépendance sert seulement à dédupliquer une liste simple.
// Avant : Dépendance utilisée juste pour retirer les doublons.
import uniq from "lodash/uniq";

const ids = uniq(users.map(user => user.id));

// Après : Fonction native suffisante pour ce cas simple.
const ids = [...new Set(users.map(user => user.id))];
Exemple Python, quand une boucle manuelle peut être remplacée par la librairie standard.
# Avant : Logique longue pour compter des occurrences.
counts = {}

for status in statuses:
    if status not in counts:
        counts[status] = 0
    counts[status] += 1

# Après : Fonction standard, plus courte et plus lisible.
from collections import Counter

counts = Counter(statuses)
Je fais quand même attention. Je ne supprime pas une dépendance critique juste pour faire court. Une dépendance de sécurité, de parsing complexe, de dates, de chiffrement ou de validation métier peut être indispensable. La validation se fait sur des cas réels, avec les tests avant et après. Sinon on fait juste du ménage cosmétique, et ça casse en prod.
Pour trancher vite, j’utilise cette petite grille.
| Option | À choisir quand |
| Code natif | Le besoin est simple, stable, lisible, et couvert par le langage ou le framework. |
| Dépendance existante | Elle est déjà dans le projet, maintenue, testée, et elle répond proprement au besoin. |
| Nouvelle dépendance | Le problème est complexe, risqué, ou trop coûteux à maintenir soi-même. |
Comment garder contexte tokens et sécurité ?
Pour garder le contexte, les tokens et la sécurité sous contrôle, je fais simple : je donne à l’agent un contexte compact, stable et vérifiable. Pas un roman. Un agent comme Claude Code ou Codex CLI travaille mieux avec une carte claire du projet qu’avec 40 fichiers balancés au hasard dans la fenêtre de contexte.
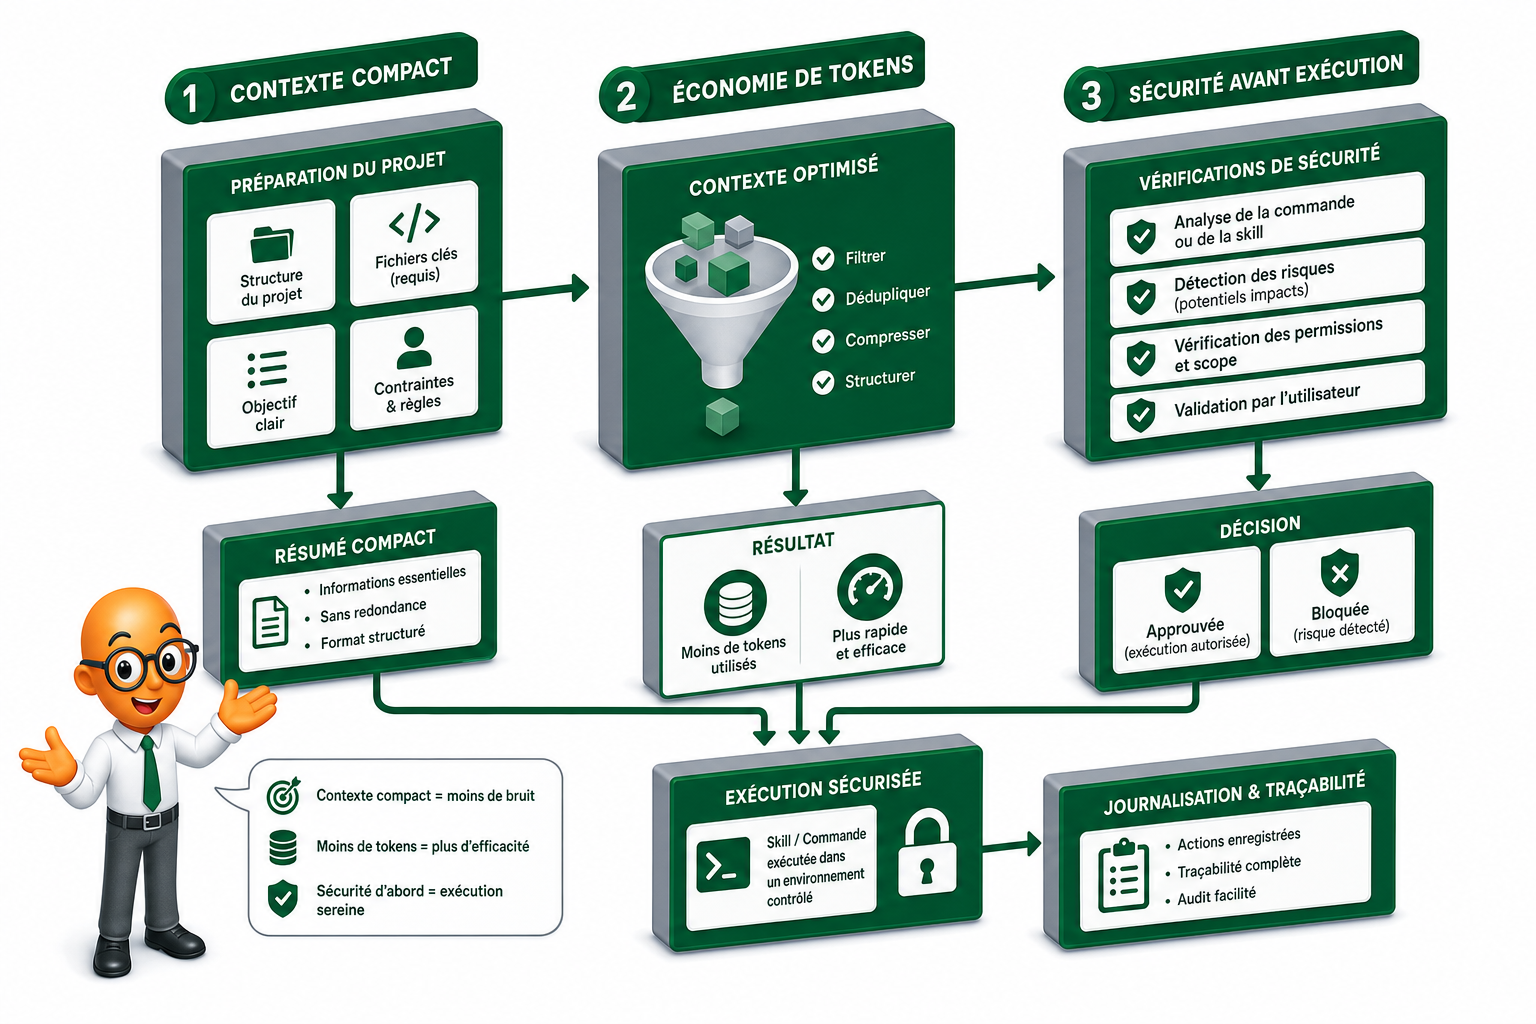
Quand j’arrive sur un codebase inconnu, je commence toujours par le faire cartographier. Le but n’est pas qu’il lise tout. Le but, c’est qu’il trouve les points d’entrée, les fichiers qui pilotent vraiment l’application, les conventions, les commandes utiles, et les zones où il ne faut pas faire n’importe quoi.
Je garde ensuite ce résumé dans CLAUDE.md, AGENTS.md ou un fichier équivalent selon l’outil. C’est votre mémoire longue. Elle évite de repayer les mêmes tokens à chaque session.
Voici le template que j’utilise souvent, à copier tel quel puis à remplir avec l’agent après une première exploration du projet.
Objectif du projet :
Décrire en 5 lignes ce que fait l’application et pour qui.

Commandes utiles :
- Installer :
- Lancer en local :
- Lancer les tests :
- Linter / formatter :

Architecture :
- Point d’entrée principal :
- Dossier backend :
- Dossier frontend :
- Dossier tests :
- Services externes utilisés :

Conventions :
- Style de code :
- Nommage :
- Gestion des erreurs :
- Pattern API / DB :

Zones sensibles :
- Authentification :
- Paiement :
- Données personnelles :
- Migrations base de données :
- Secrets et variables d’environnement :

Décisions déjà prises :
- Ne pas remplacer :
- Ne pas refactorer sans demande :
- Préférer :
- Éviter :
J’ajoute aussi une skill de réduction de tokens. Elle sert à finir proprement une session, surtout quand on change de tâche ou qu’on approche de la limite de contexte.
Résume la session précédente de manière compacte.

Inclus uniquement :
- Décisions prises
- Fichiers modifiés
- Tests lancés et résultats
- Risques ouverts
- Prochaine action recommandée

Évite les détails inutiles.
Écris ce résumé pour qu’il puisse être collé dans CLAUDE.md ou AGENTS.md.
Côté sécurité, je ne lance jamais une skill à l’aveugle. Une skill, c’est du comportement automatisé. Si elle peut lire, écrire, installer, appeler le réseau ou exécuter des commandes, elle peut aussi casser des choses. J’ai déjà vu un agent “nettoyer” un repo en supprimant des fichiers générés… qui étaient en fait utilisés en prod. Pas drôle.
Avant d’installer ou d’exécuter une skill, je vérifie ces points :
- Les permissions demandées sont-elles vraiment nécessaires ?
- La skill peut-elle lancer des commandes destructrices comme rm, drop, reset, delete ou migrate ?
- La skill peut-elle lire des secrets, des fichiers .env, des tokens API ou des clés SSH ?
- Ajoute-t-elle des dépendances inconnues ou non maintenues ?
- Envoie-t-elle du code, des logs ou des fichiers vers un service externe ?
- Modifie-t-elle des fichiers critiques sans validation humaine ?
- Demande-t-elle une confirmation avant chaque action risquée ?
Ma checklist finale est courte : contexte projet à jour, résumé de session sauvegardé, commandes de test connues, zones sensibles identifiées, permissions relues, accès secrets bloqué, dépendances vérifiées, exécution d’abord sur une branche dédiée. Si une skill échoue à deux de ces points, je ne l’exécute pas.
Alors quelle skill j’installerais en premier ?
J’installerais d’abord une skill qui clarifie le besoin, limite le périmètre et impose des tests. C’est la base. Après, j’ajoute une skill de simplification du code, puis un agent harness si l’équipe a besoin de rôles séparés pour coder, relire, corriger et sécuriser. Le vrai gain avec Claude Code et Codex CLI vient de cette discipline. Moins de flou, moins de dépendances inutiles, moins de tokens gaspillés, plus de résultats vérifiables. Vous ne cherchez pas juste à faire coder une IA, vous cherchez à garder le contrôle du code qu’elle produit.
FAQ
- Quelle est la meilleure skill pour commencer avec Claude Code ou Codex CLI ?
Je commencerais par une skill de cadrage développement. Elle force l’agent à poser des questions, proposer un plan court, modifier seulement ce qui est nécessaire et lancer les tests disponibles. C’est celle qui évite le plus d’erreurs bêtes.
- Une skill remplace-t-elle un bon prompt ?
Non, elle le rend réutilisable. Un prompt sert souvent à une demande ponctuelle. Une skill formalise une façon de travailler, avec des règles, des validations et parfois des rôles. C’est plus stable quand on code régulièrement avec une IA.
- Pourquoi demander à l’IA de poser des questions avant de coder ?
Parce qu’un agent qui part trop vite compense le manque de contexte avec des suppositions. Et ces suppositions finissent dans votre code. Les questions réduisent le flou, surtout sur le périmètre, les fichiers concernés, les tests attendus et les contraintes métier.
- Quand faut-il utiliser un agent harness plutôt qu’une skill simple ?
Je l’utiliserais quand plusieurs responsabilités doivent être séparées. Par exemple architecture, implémentation, revue de code, correction et sécurité. Pour une petite tâche, c’est souvent trop lourd. Pour une équipe ou un codebase sensible, ça devient utile.
- Comment vérifier qu’une skill est sûre avant de l’utiliser ?
Je regarde les commandes qu’elle peut déclencher, les permissions demandées, les accès aux secrets, les dépendances ajoutées et les actions destructrices possibles. Une skill utile doit être claire, limitée et vérifiable. Si elle demande trop de pouvoir sans justification, je ne l’installe pas.
A propos de l’auteur
Je suis Franck Scandolera, expert et formateur en Tracking avancé server-side, Analytics Engineering, automatisation No/Low Code avec n8n, intégration de l’IA en entreprise et SEO/GEO. Avec mon agence webAnalyste et mon organisme Formations Analytics, j’accompagne des équipes qui veulent passer de l’expérimentation IA à des workflows fiables, mesurables et maintenables. J’ai travaillé avec des clients comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Si vous voulez structurer vos usages IA, vos automatisations ou vos données, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.