
Il faut assembler plusieurs couches, pas juste coder une boucle LLM. Je vous montre les outils utiles pour structurer l’agent, isoler son code, garder sa mémoire, observer ses erreurs et le faire tenir en production.
Pourquoi LangGraph change la base ?
LangGraph change la base parce qu’il oblige à arrêter de penser “boucle magique dans un notebook”. Un agent en production, ce n’est pas juste un LLM qui réfléchit, appelle un outil, recommence, puis répond. C’est une exécution avec des chemins possibles, des erreurs, des reprises, parfois un humain au milieu, et surtout un état qu’on doit comprendre.
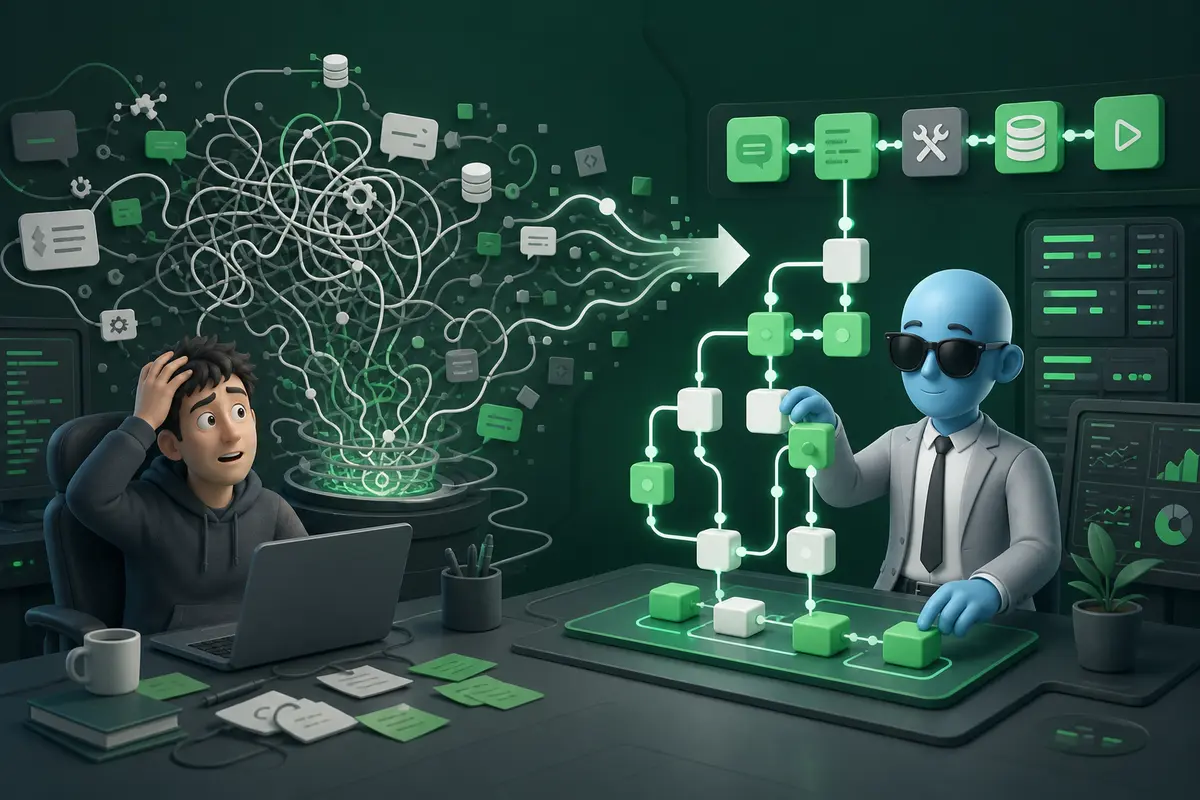
Dans un notebook, tout tient tant que ça marche du premier coup. Dès qu’un appel API plante, qu’un utilisateur revient 20 minutes après, ou qu’un manager doit valider une action sensible, la boucle devient fragile. Avec LangGraph, je modélise l’agent comme un graphe : des nœuds, des transitions, un état partagé, et des checkpoints. Un checkpoint, c’est une sauvegarde de l’exécution à un instant précis.
Il y a un piège que je vois souvent chez les clients. On teste avec un checkpointer mémoire, donc stocké localement dans le process Python. Ça marche en démo. Puis on oublie de le remplacer avant la mise en production. Là, au redémarrage du serveur, tout disparaît. En production, je mets un checkpointer persistant, typiquement Postgres. La mémoire courte durée sert à piloter l’exécution en cours. La persistance durable sert à reprendre, auditer, rejouer et déboguer.
Voici un exemple simple. Il montre un état, deux nœuds, une bifurcation conditionnelle, et une compilation avec un checkpointer Postgres persistant.
from typing import TypedDict
from langgraph.graph import StateGraph, START, END
from langgraph.checkpoint.postgres import PostgresSaver

class AgentState(TypedDict):
    question: str
    reponse: str
    needs_human: bool

def analyser(state: AgentState) -> AgentState:
    # Cette étape décide si la demande est sensible.
    sensible = "remboursement" in state["question"].lower()
    return {
        **state,
        "needs_human": sensible
    }

def finaliser(state: AgentState) -> AgentState:
    # Cette étape produit une réponse simple si aucun humain n'est nécessaire.
    return {
        **state,
        "reponse": "Réponse générée automatiquement."
    }

def router(state: AgentState) -> str:
    # Si c'est sensible, on arrête ici pour laisser un humain valider.
    if state["needs_human"]:
        return "validation_humaine"
    return "finaliser"

builder = StateGraph(AgentState)

builder.add_node("analyser", analyser)
builder.add_node("finaliser", finaliser)

builder.add_edge(START, "analyser")
builder.add_conditional_edges(
    "analyser",
    router,
    {
        "validation_humaine": END,
        "finaliser": "finaliser"
    }
)
builder.add_edge("finaliser", END)

DB_URI = "postgresql://postgres:postgres@localhost:5432/agents?sslmode=disable"

with PostgresSaver.from_conn_string(DB_URI) as checkpointer:
    # Cette ligne crée les tables nécessaires au stockage des checkpoints.
    checkpointer.setup()

    graph = builder.compile(checkpointer=checkpointer)

    result = graph.invoke(
        {
            "question": "Je veux un remboursement urgent",
            "reponse": "",
            "needs_human": False
        },
        config={
            "configurable": {
                "thread_id": "conversation-123"
            }
        }
    )

print(result)| Cas d’usage | Ce que LangGraph apporte |
| Reprise après erreur | Je repars du dernier checkpoint au lieu de relancer toute l’exécution. |
| Validation humaine | Je suspends le flux quand une décision doit être validée. |
| Audit d’exécution | Je garde une trace claire des étapes, des états et des décisions. |
| Debug temporel | Je peux revenir dans le temps pour comprendre où l’agent a dévié. |
Quand isoler le code avec E2B ?
Dès qu’un agent peut écrire ou exécuter du code, je l’isole. Même pour un bout de Python qui “fait juste un calcul”. Parce qu’un script peut lire des fichiers, appeler une API externe, boucler trop longtemps, saturer la mémoire ou casser l’environnement courant. Ce n’est pas forcément malveillant. C’est souvent juste du code généré trop vite, avec une hypothèse bancale.
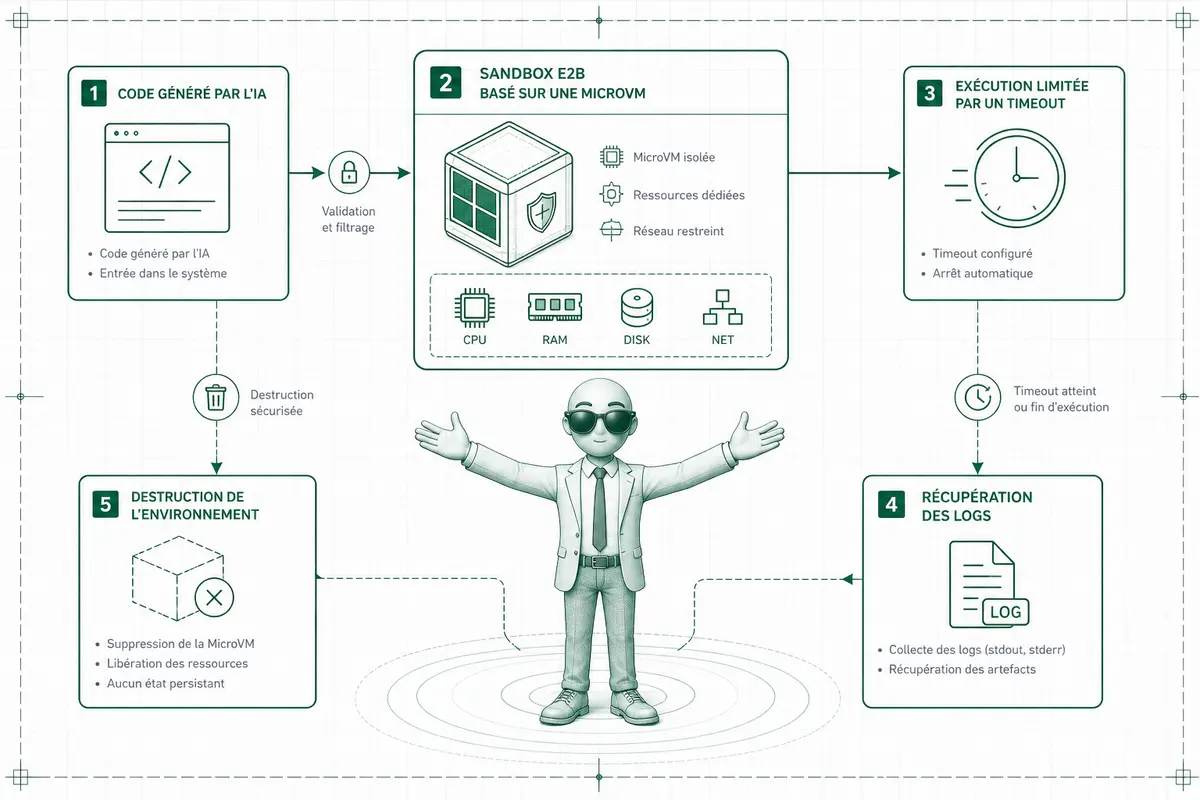
E2B sert à ça. Je l’utilise comme un environnement jetable, séparé du reste, où l’IA peut exécuter son code sans toucher à ma machine, à mon serveur ou à mes données sensibles. Techniquement, E2B s’appuie sur des microVM Firecracker. Une microVM, c’est une petite machine virtuelle très légère. C’est plus isolant qu’un simple conteneur Docker classique, parce que la séparation avec l’hôte est plus forte.
Les bons cas d’usage sont assez clairs. Calcul court, manipulation de fichiers temporaires, analyse de données, test d’un script, génération d’un graphique ou d’un résultat. J’ai vu ça très bien marcher chez un client qui laissait un agent produire du Python pour nettoyer des CSV. Avant E2B, le risque était que le script parte lire n’importe quoi sur le serveur. Après, chaque exécution repartait dans une boîte propre.
La limite à garder en tête : E2B n’est pas fait pour des traitements très longs ou des jobs qui doivent rester vivants pendant des heures. Là, je préfère une vraie file de jobs, avec workers, reprise sur erreur et supervision.
Voici un exemple simple. Le sandbox exécute un script court, récupère la sortie, applique un timeout, puis détruit l’environnement.
import os
from e2b import Sandbox

sandbox = None

try:
    # Crée un environnement isolé et jetable.
    sandbox = Sandbox(api_key=os.environ["E2B_API_KEY"])

    # Écrit un petit script temporaire dans le sandbox.
    sandbox.files.write(
        "/tmp/script.py",
        """
import math

values = [1, 4, 9, 16]
result = [math.sqrt(x) for x in values]

print(result)
"""
    )

    # Exécute le script avec un timeout court.
    # Utile pour éviter les boucles infinies et les scripts trop gourmands.
    execution = sandbox.commands.run(
        "python /tmp/script.py",
        timeout=5
    )

    # Récupère la sortie standard.
    print("Sortie :", execution.stdout)

    # Récupère les erreurs éventuelles.
    if execution.stderr:
        print("Erreur :", execution.stderr)

finally:
    # Détruit toujours l’environnement, même si le script plante.
    if sandbox is not None:
sandbox.kill()- Timeout systématique. Aucun code généré par l’IA ne doit tourner sans limite.
- Pas de secrets. Je n’injecte jamais de clés API ou de données sensibles si ce n’est pas strictement nécessaire.
- Quotas clairs. Je limite CPU, mémoire, durée et volume de fichiers quand c’est possible.
- Logs conservés. Je garde stdout, stderr et le code exécuté pour comprendre les erreurs.
- Environnement jetable. Une exécution, un sandbox propre, puis destruction.
Comment donner une vraie mémoire à l’agent ?
Je vois souvent le même piège avec les agents IA : on appelle “mémoire” tout ce qui ressemble à un historique. Mais une vraie mémoire, c’est autre chose. C’est ce que l’agent doit pouvoir retrouver dans trois jours, pas juste ce qui l’aide à finir l’action en cours.
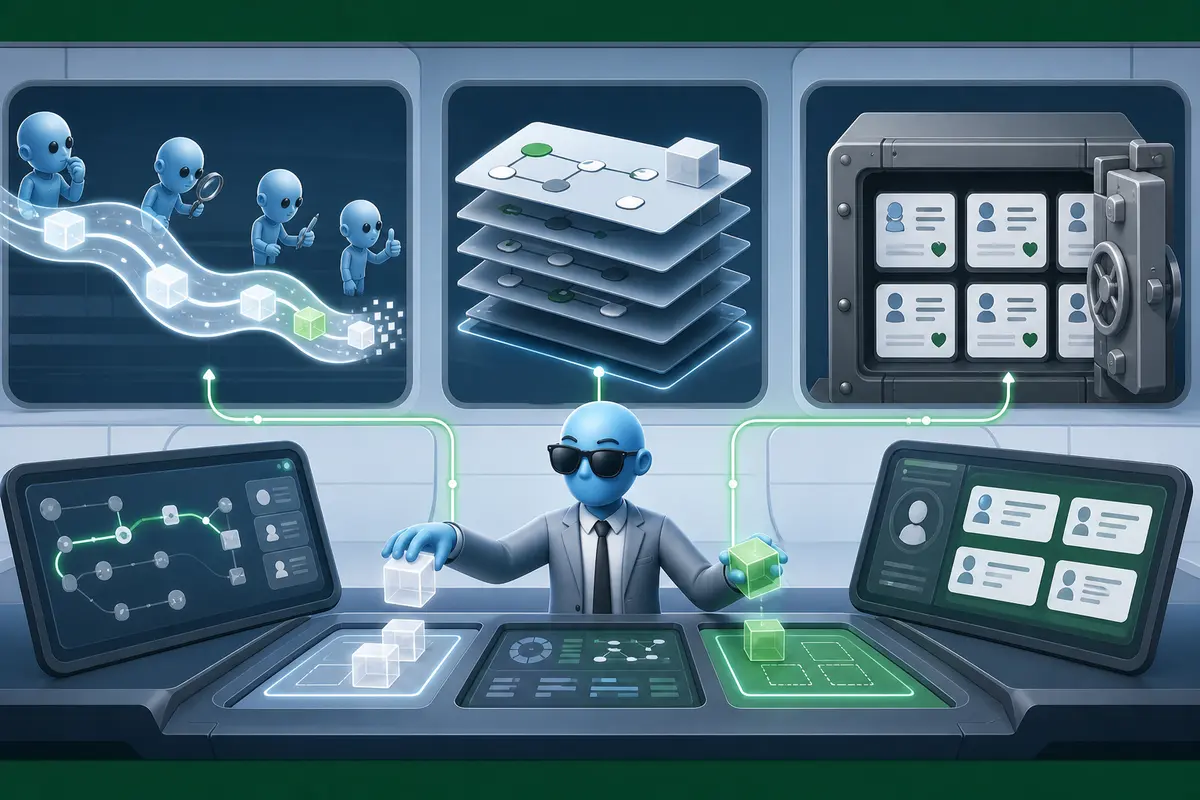
LangGraph garde très bien l’état du workflow. Par exemple : quelle étape est en cours, quel outil vient d’être appelé, quelle réponse attendre. C’est une mémoire courte, utile pour piloter l’exécution. Mem0, lui, sert à garder des souvenirs durables : préférences, faits, contraintes, habitudes. Il extrait les infos utiles d’une conversation, les stocke, puis les retrouve plus tard avec une recherche ciblée.
Exemple simple : un utilisateur préfère des réponses courtes, travaille en français, utilise Postgres et n’aime pas les outils trop lourds. Je veux que l’agent s’en souvienne. Mais je ne veux pas qu’il mémorise chaque phrase, ni des données sensibles inutiles. Le user_id devient clé ici : il rattache les souvenirs à la bonne personne. Il faut aussi gérer le consentement, la suppression des données, et la minimisation. On garde le minimum utile, pas plus.
| Type | Rôle | Durée |
| Mémoire de session | Historique immédiat de la conversation | Courte |
| Checkpoint d’exécution | État technique du workflow LangGraph | Pendant l’exécution |
| Mémoire durable | Préférences et faits utiles avec Mem0 | Entre les sessions |
Ce code sert à ajouter une mémoire utilisateur, retrouver les souvenirs pertinents, puis les injecter dans le contexte avant l’appel au modèle. C’est utile dès qu’un agent doit personnaliser ses réponses sans redemander les mêmes infos.
from mem0 import MemoryClient
from openai import OpenAI

mem0 = MemoryClient(api_key="MEM0_API_KEY")
llm = OpenAI(api_key="OPENAI_API_KEY")

user_id = "user_123"

# On ajoute une mémoire utile, avec consentement utilisateur.
mem0.add(
    messages=[
        {
            "role": "user",
            "content": "Je préfère des réponses courtes, en français. J'utilise Postgres et je n'aime pas les outils trop lourds."
        }
    ],
    user_id=user_id
)

question = "Quel outil me conseilles-tu pour automatiser mes exports de données ?"

# On recherche seulement les souvenirs pertinents pour cette demande.
memories = mem0.search(
    query=question,
    user_id=user_id,
    limit=5
)

memory_context = "n".join(
    [m["memory"] for m in memories]
)

# On injecte la mémoire durable dans le contexte du modèle.
response = llm.chat.completions.create(
    model="gpt-4.1-mini",
    messages=[
        {
            "role": "system",
            "content": f"Réponds en tenant compte de ces souvenirs utilisateur :n{memory_context}"
        },
        {
            "role": "user",
            "content": question
        }
    ]
)

print(response.choices[0].message.content)
Le bon réflexe, c’est de séparer les couches. LangGraph pilote. Mem0 se souvient. Et l’agent devient plus fiable parce qu’il sait quoi garder, quoi oublier, et quoi ne jamais stocker.
Comment voir ce que fait l’agent ?
Quand un agent part de travers, le vrai sujet n’est pas juste “il s’est trompé”. C’est “qu’est-ce qui l’a fait se tromper ?”. Sans trace, on est aveugle. On regarde la réponse finale, on devine, on modifie un prompt au hasard, et on crée parfois un autre bug ailleurs.
LangSmith sert justement à éviter ça. C’est un outil d’observabilité pour applications LLM et agents. Observabilité, ça veut dire que je peux voir ce qui se passe à l’intérieur : le prompt envoyé, le modèle appelé, les outils utilisés, les entrées et sorties de chaque étape, la latence, le coût, les erreurs, les retries, et même l’identifiant utilisateur quand le cadre légal et produit l’autorise.
Avec LangGraph, c’est encore plus utile. Chaque nœud du graphe peut devenir lisible dans une trace. Je vois le nœud qui décide, celui qui appelle un outil, celui qui relit, celui qui bloque ou passe en validation humaine. Ça change tout. Chez un client, le gain le plus rapide n’est pas venu d’un nouveau modèle. C’est venu du simple fait de retrouver la décision exacte qui avait mené à une mauvaise action. En deux minutes, on avait la cause. Avant, l’équipe passait une demi-journée à refaire le film.
Voici un exemple simple de configuration Python. C’est utile dès que vous voulez suivre vos runs par projet, filtrer par tags, et rattacher une exécution à un identifiant unique.
import os
import uuid
from langchain_openai import ChatOpenAI
from langchain_core.runnables import RunnableConfig

# Active le tracing LangSmith
os.environ["LANGSMITH_TRACING"] = "true"
os.environ["LANGSMITH_ENDPOINT"] = "https://api.smith.langchain.com"
os.environ["LANGSMITH_API_KEY"] = "lsv2_votre_cle_api"

# Regroupe les traces dans un projet lisible
os.environ["LANGSMITH_PROJECT"] = "agent-support-prod"

# Identifiant unique de cette exécution
run_id = uuid.uuid4()

# Tags et métadonnées pour retrouver facilement les traces
config = RunnableConfig(
    run_id=run_id,
    tags=["prod", "support", "agent-v2"],
    metadata={
        "user_id": "user_123",      # À tracer seulement si c'est autorisé
        "ticket_id": "TCK-9842"
    }
)

model = ChatOpenAI(
    model="gpt-4o-mini",
    temperature=0
)

response = model.invoke(
    "Résume le ticket client et propose la prochaine action.",
    config=config
)

print(response.content)
Les métriques à surveiller en priorité sont simples, mais elles disent vite si votre agent est fiable ou non.
- Taux d’erreur.
- Latence moyenne et latence maximale.
- Coût par tâche réussie.
- Outil le plus appelé.
- Taux de retries.
- Taux d’intervention humaine.
Comment déployer sans casser en charge ?
On déploie sans casser en charge quand on arrête de voir l’agent comme un script qui tourne dans un coin. Je le traite comme un vrai service applicatif, avec une API, des workers, une file de tâches si les traitements sont longs, une base de checkpoints, une mémoire externe, de l’observabilité et des limites de ressources. C’est moins sexy qu’une démo, mais c’est ce qui évite les surprises le lundi matin.
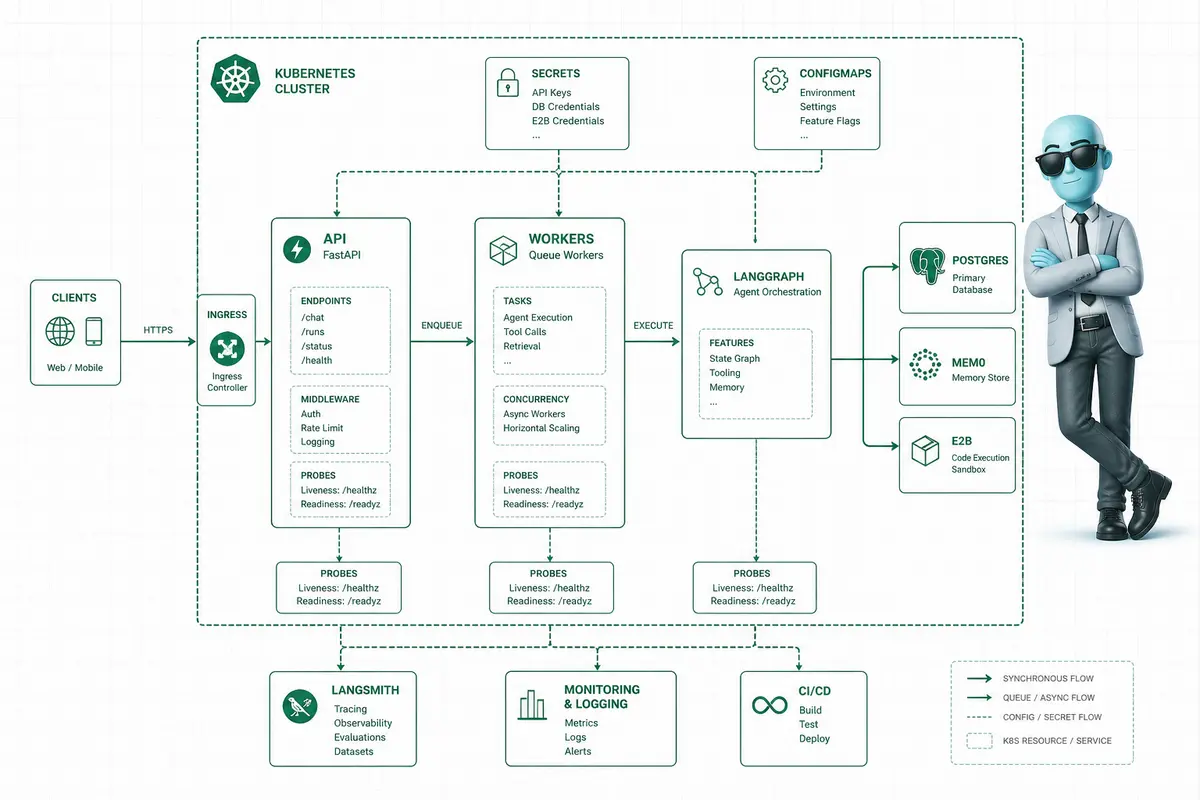
Dans une stack propre, LangGraph orchestre les étapes de l’agent, Postgres garde les checkpoints pour reprendre un run interrompu, E2B isole le code dangereux dans un sandbox, Mem0 stocke la mémoire longue, et LangSmith trace chaque appel pour comprendre ce qui s’est passé. Kubernetes devient crédible quand l’entreprise a déjà cette maturité : pods, autoscaling, secrets, probes de santé, redémarrage automatique. Pour un petit agent interne, je peux commencer avec Docker Compose ou un service managé, mais je garde les mêmes principes.
Ce service expose un endpoint HTTP simple. Il reçoit une demande, invoque le graphe LangGraph, et laisse les couches derrière faire leur travail.
from fastapi import FastAPI
from pydantic import BaseModel

# Le graphe contient la logique agentique LangGraph déjà compilée
from my_agent.graph import graph

app = FastAPI()

class AgentRequest(BaseModel):
    thread_id: str
    message: str

@app.get("/health")
def health():
    return {"status": "ok"}

@app.post("/invoke")
def invoke_agent(req: AgentRequest):
    # thread_id sert à retrouver les checkpoints Postgres
    result = graph.invoke(
        {"messages": [{"role": "user", "content": req.message}]},
        config={"configurable": {"thread_id": req.thread_id}}
    )
    return {"result": result}
Ce manifeste Kubernetes montre le minimum sérieux. Je passe les variables sensibles via env vars ou secrets, je limite CPU et mémoire, et je donne à Kubernetes un endpoint pour savoir si le service peut recevoir du trafic.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: agent-service
spec:
  replicas: 2
  selector:
    matchLabels:
      app: agent-service
  template:
    metadata:
      labels:
        app: agent-service
    spec:
      containers:
        - name: agent-service
          image: registry.example.com/agent-service:1.0.0
          ports:
            - containerPort: 8000
          env:
            - name: POSTGRES_URL
              valueFrom:
                secretKeyRef:
                  name: agent-secrets
                  key: postgres_url
            - name: LANGSMITH_API_KEY
              valueFrom:
                secretKeyRef:
                  name: agent-secrets
                  key: langsmith_api_key
            - name: MEM0_API_KEY
              valueFrom:
                secretKeyRef:
                  name: agent-secrets
                  key: mem0_api_key
          readinessProbe:
            httpGet:
              path: /health
              port: 8000
            initialDelaySeconds: 5
            periodSeconds: 10
          resources:
            requests:
              cpu: "250m"
              memory: "512Mi"
            limits:
              cpu: "1"
              memory: "1Gi"
| Niveau | Approche | Risque acceptable |
| Prototype | Un service simple, logs basiques, secrets locaux | Casser sans impact métier |
| Pilote interne | API stable, Postgres, traces LangSmith, limites ressources | Incident visible mais maîtrisé |
| Production réelle | Kubernetes, autoscaling, probes, workers, files, secrets, monitoring | Dégradation contrôlée, pas d’arrêt brutal |
Vous voulez un agent IA qui tient vraiment ?
Un agent IA fiable, ce n’est pas un prompt malin branché sur trois outils. C’est une petite architecture. LangGraph pose le squelette et la reprise d’exécution. E2B sécurise le code généré. Mem0 garde les informations utiles dans le temps. LangSmith rend les décisions visibles. Kubernetes, ou une couche équivalente, aide à tenir la charge proprement. Mon conseil est simple, ne cherchez pas à tout industrialiser dès le premier jour, mais ne construisez pas non plus sur du sable. Si vous posez ces couches dès le départ, vous gagnez en stabilité, en sécurité et en temps de debug.
FAQ
- Pourquoi un agent IA ne suffit pas dans un notebook ?
Un notebook sert très bien à tester une idée, mais il ne gère pas correctement la persistance, les erreurs, les reprises, les traces, les accès sécurisés et la montée en charge. En production, l’agent doit être observable, redémarrable et contrôlable. - À quoi sert LangGraph pour un agent IA ?
LangGraph sert à structurer l’agent comme un graphe avec des étapes, des conditions, un état partagé et des checkpoints. C’est utile pour reprendre une exécution, ajouter une validation humaine, suivre une branche de décision et déboguer ce qui s’est passé. - Pourquoi utiliser E2B plutôt qu’un simple conteneur ?
E2B isole l’exécution de code généré par l’IA dans des environnements jetables basés sur des microVM Firecracker. C’est plus adapté quand l’agent doit exécuter du code non fiable, avec des limites de temps, de fichiers et de ressources. - Mem0 remplace-t-il les checkpoints LangGraph ?
Non. Les checkpoints servent à reprendre une exécution ou à conserver l’état d’un workflow. Mem0 sert plutôt à mémoriser des faits et préférences utiles entre plusieurs sessions. Les deux couches se complètent. - Quel outil choisir en premier pour passer en production ?
Je commencerais par LangGraph si l’agent a plusieurs étapes ou décisions. Ensuite j’ajouterais l’observabilité avec LangSmith, puis E2B si l’agent exécute du code, Mem0 si la mémoire utilisateur compte, et une vraie couche de déploiement quand la charge augmente.
A propos de l’auteur
Je suis Franck Scandolera, responsable de l’agence webAnalyste et de l’organisme Formations Analytics. J’accompagne des équipes sur le tracking server-side, l’Analytics Engineering, l’automatisation No/Low Code avec n8n, l’intégration de l’IA en entreprise et le SEO/GEO. J’ai travaillé pour des clients comme Logis Hôtel, Yelloh Village, BazarChic, la Fédération Française de Football ou Texdecor. Si vous voulez mettre en production des agents IA utiles, observables et raccordés à votre business, contactez-moi.

⭐ Analytics engineer, Data Analyst et Automatisation IA indépendant ⭐
- Ref clients : Logis Hôtel, Yelloh Village, BazarChic, Fédération Football Français, Texdecor…
Mon terrain de jeu :
- Data Analyst & Analytics engineering : tracking avancé (GTM server, e-commerce, CAPI, RGPD), entrepôt de données (BigQuery, Snowflake, PostgreSQL, ClickHouse), modèles (Airflow, dbt, Dataform), dashboards décisionnels (Looker, Power BI, Metabase, SQL, Python).
- Automatisation IA des taches Data, Marketing, RH, compta etc : conception de workflows intelligents robustes (n8n, App Script, scraping) connectés aux API de vos outils et LLM (OpenAI, Mistral, Claude…).
- Engineering IA pour créer des applications et agent IA sur mesure : intégration de LLM (OpenAI, Mistral…), RAG, assistants métier, génération de documents complexes, APIs, backends Node.js/Python.